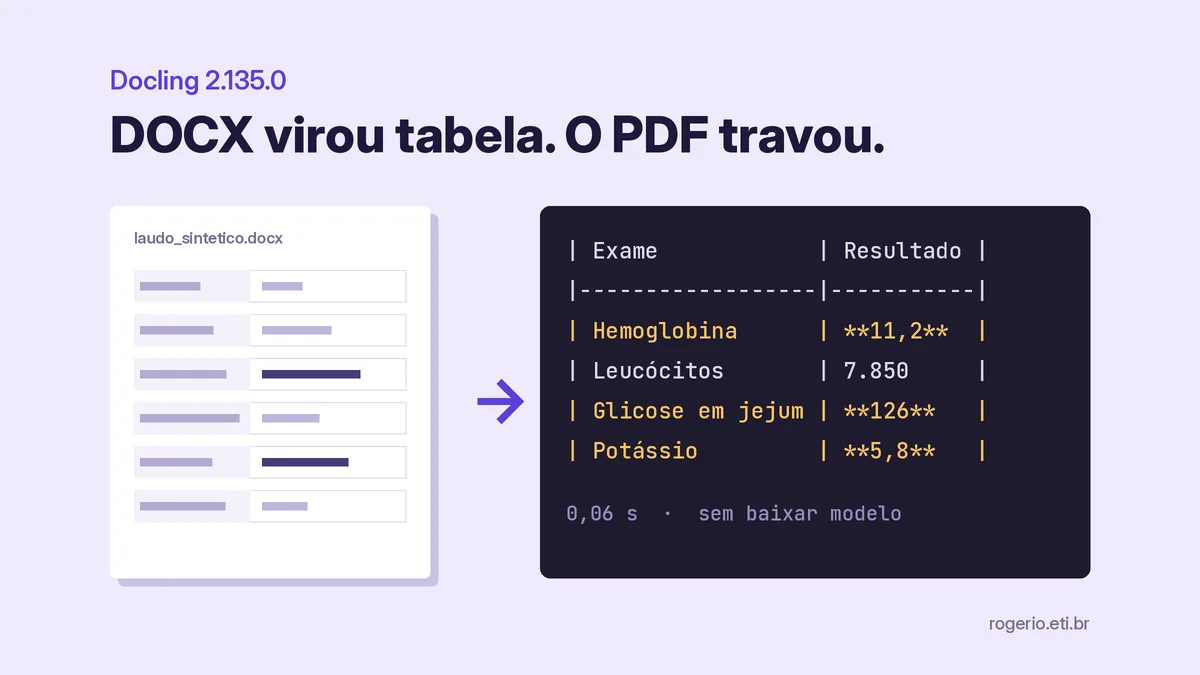
Rodei o Docling 2.135.0 num laudo de exames fictício. Em DOCX e XLSX, docling laudo_sintetico.docx exames_sinteticos.xlsx --to md devolveu tabela Markdown limpa em 0,06 s e 0,02 s, com o negrito dos resultados fora da referência preservado e sem baixar modelo nenhum. No PDF, travou: o pipeline de PDF precisa baixar modelos de layout e de tabela, e a rede do ambiente onde rodei bloqueia esses downloads. E um detalhe que muda a leitura do changelog: a melhoria de tabela Markdown da v2.135.0 é na leitura de arquivos .md. Na exportação, o mesmo DOCX saiu idêntico na 2.134.0.
Abaixo, o comando, a saída real e o que eu faria pra rodar o PDF de verdade.
O que o Docling faz e por que isso importa pro LLM
Docling é um conversor de documentos open source, licença MIT, iniciado pela IBM Research Zurich e hoje hospedado na LF AI & Data Foundation. Ele lê PDF, DOCX, PPTX, XLSX, HTML, EPUB, Markdown e outros formatos, monta uma representação única do documento e exporta pra Markdown, JSON, HTML ou texto. Roda local.
O motivo de usar antes do LLM é simples. Laudo de laboratório é tabela. Se o PDF sai como texto corrido, a linha “Potássio 5,8 mEq/L 3,5 a 5,1” pode virar uma sopa de números e o modelo precisa adivinhar qual é resultado e qual é referência. Em Markdown com pipes, cada valor fica preso à coluna. No RAG, o chunk carrega o cabeçalho junto. Menos chute.
O que mudou na v2.135.0, lido no changelog
A versão saiu em 07/10/2026 no GitHub e no PyPI. Duas features e 27 correções:
| Mudança | PR | O que faz | Testei? |
|---|---|---|---|
| iwork | #4630 | Renderiza imagem de gráfico do Numbers e lê os tipos de gráfico do iWork ’09 | Não. Não tenho arquivo .numbers sintético |
| md | #4488 | Preserva formatação inline (negrito, itálico, código, link) dentro de célula de tabela em arquivo Markdown de entrada | Sim, 2.134.0 contra 2.135.0 |
A pauta que chegou pra mim dizia “exporta tabela Markdown melhor”. Fui no PR. A descrição é clara: o MarkdownDocumentBackend lia células de tabela como texto puro e jogava fora a marcação. Agora usa o parser GFM do Marko e guarda a formatação. É entrada, não saída.
O teste: um laudo fictício em três formatos
Instalação
python3 -m venv .venv
.venv/bin/pip install "docling==2.135.0" reportlab
.venv/bin/docling --version
# Docling version: 2.135.0
# Docling Core version: 2.100.0
# Docling Parse version: 7.22.2
Gerei o mesmo laudo em PDF (reportlab), DOCX (python-docx) e XLSX (openpyxl). Paciente inventada, seis exames. No DOCX, os resultados fora da referência vão em negrito, como muito laboratório faz:
fora = {"Hemoglobina", "Glicose em jejum", "Potássio"}
for i, row in enumerate(linhas):
    cells = t.add_row().cells
    for j, v in enumerate(row):
        r = cells[j].paragraphs[0].add_run(v)
        if j == 1 and row[0] in fora:
            r.bold = True   # resultado fora da referência em negrito
PDF: parou no download de modelo
docling laudo_sintetico.pdf --to md --output out
# rapidocr...DownloadFileException: Failed to download
#   https://www.modelscope.cn/.../PP-OCRv6_det_small.pth

docling laudo_sintetico.pdf --no-ocr --to md --output out
# httpx.ProxyError: 403 Forbidden
Primeira tentativa: o OCR padrão (RapidOCR) tenta baixar pesos do ModelScope. Desliguei o OCR, porque o PDF é nascido digital e tem camada de texto. Segunda tentativa: caiu em httpx.ProxyError: 403 Forbidden. O log não diz o host. A política de rede da máquina nega huggingface.co, download.pytorch.org e modelscope.cn. Nenhum Markdown saiu do PDF. Então não tenho resultado próprio de tabela extraída de PDF pra mostrar aqui.
DOCX e XLSX: Markdown limpo, sem modelo
docling laudo_sintetico.docx exames_sinteticos.xlsx --to md --output outSaída real do DOCX:
## Laboratório Fictício Ltda - Laudo de exames

Paciente: Maria Teste da Silva (dado sintético) - Coleta: 01/10/2026

| Exame            | Resultado   | Unidade   | Referência     |
|------------------|-------------|-----------|----------------|
| Hemoglobina      | **11,2**    | g/dL      | 12,0 a 15,5    |
| Leucócitos       | 7.850       | /mm³      | 4.000 a 11.000 |
| Glicose em jejum | **126**     | mg/dL     | 70 a 99        |
| Creatinina       | 0,9         | mg/dL     | 0,5 a 1,1      |
| Potássio         | **5,8**     | mEq/L     | 3,5 a 5,1      |
| TSH              | 2,1         | µUI/mL    | 0,4 a 4,0      |

Valores em negrito estão fora da referência.
Acento, µ e ³ intactos. Vírgula decimal brasileira intacta. O negrito que marca o valor alterado chegou até o Markdown, e é isso que o LLM vai ler. A planilha saiu com a mesma tabela, sem negrito porque eu não formatei a XLSX. DOCX e XLSX usam backends declarativos: leem a estrutura do arquivo, sem rede neural. Por isso rodaram mesmo com os downloads bloqueados.
Rodei o mesmo DOCX no Docling 2.134.0. Saída idêntica, diff vazio. Pra esse caso, atualizar não muda nada.
Tabela em Markdown como entrada: aqui a v2.135.0 aparece
Escrevi um .md com tabela que tem negrito, código e link nas células, e passei pelas duas versões com --from md --to md. Entrada:
# Exames de controle (dado sintético)

| Exame | Resultado | Referência |
|---|---|---|
| Glicose em jejum | **126** mg/dL | 70 a 99 |
| Potássio | **5,8** mEq/L | 3,5 a 5,1 |
| TSH | 2,1 µUI/mL | 0,4 a 4,0 |
| Creatinina | `0,9` mg/dL | [ver protocolo](https://example.org/protocolo) |
Comando e saída nas duas versões (trecho):
docling exames_sinteticos.md --from md --to md --output out# 2.134.0
| Glicose em jejum | 126 mg/dL | 70 a 99 |
| Potássio | 5,8 mEq/L | 3,5 a 5,1 |
| Creatinina | 0,9 mg/dL | ver protocolo |
# 2.135.0
| Glicose em jejum | **126** mg/dL | 70 a 99 |
| Potássio | **5,8** mEq/L | 3,5 a 5,1 |
| Creatinina | `0,9` mg/dL | [ver protocolo](https://example.org/protocolo) |Na 2.134.0, o negrito sumia e o link virava só o texto. A URL ia embora. Na 2.135.0, tudo fica. Se o seu RAG ingere documentação interna em Markdown, wiki exportada ou protocolo escrito em .md, essa é a mudança que interessa: o link pro protocolo agora chega no chunk.
Como rodar o PDF com os modelos (pela documentação)
Esta parte eu não consegui executar. É o caminho que a documentação oficial descreve pra ambiente sem internet: baixar os modelos numa máquina com acesso e apontar o conversor pra pasta.
docling-tools models download
# baixa layout, tableformer, picture classifier, code formula e RapidOCR
# em $HOME/.cache/docling/models
from docling.datamodel.base_models import InputFormat
from docling.datamodel.pipeline_options import PdfPipelineOptions, TableFormerMode
from docling.document_converter import DocumentConverter, PdfFormatOption
opts = PdfPipelineOptions(artifacts_path="/opt/docling-models")
opts.do_ocr = False # PDF nascido digital
opts.do_table_structure = True
opts.table_structure_options.mode = TableFormerMode.ACCURATE
conv = DocumentConverter(
format_options={InputFormat.PDF: PdfFormatOption(pipeline_options=opts)}
)
md = conv.convert("laudo_sintetico.pdf").document.export_to_markdown()Confirmei que esse código importa e instancia o conversor na 2.135.0. A conversão do PDF em si ficou sem rodar. Na CLI, o equivalente é --artifacts-path e --table-mode accurate.
Limites e o que não funcionou
- PDF sem rede não roda de primeira. O pip instala o pacote, mas os modelos vêm depois, na primeira conversão. Em servidor de hospital com saída bloqueada, você descobre isso em produção se não fizer o prefetch antes.
- O OCR padrão baixa de outro lugar. No meu teste, o RapidOCR foi buscar pesos no ModelScope, fora do Hugging Face. Liberar só um host no firewall não basta.
- Não testei a extração de tabela de PDF. Qualidade de TableFormer em laudo brasileiro com célula mesclada, cabeçalho repetido por página e rodapé de assinatura segue sem medição minha.
- Não testei o Numbers. A feature de gráfico do iWork está só lida no changelog.
- Markdown limpo não é Markdown anônimo. O nome da paciente fictícia passou inteiro pra saída. Anonimizar é outra etapa, e o que acontece quando ela falha eu contei em A IA achou o CPF. E o CPF vazou mesmo assim.
Quando não usar
- O dado já nasce estruturado. Exame que vem de HL7, FHIR ou banco do LIS não precisa virar PDF e voltar. Leia a fonte.
- Você só tem XLSX ou CSV simples. pandas resolve com menos dependência. O Docling compensa quando há mistura de formatos.
- Seu ambiente não pode baixar modelo nem receber pasta de modelo por outro caminho. Aí o pipeline de PDF não sai do lugar.
- O PDF é escaneado e de baixa qualidade. OCR erra dígito, e dígito errado em potássio é problema clínico. Precisa de revisão humana de qualquer jeito.
Fonte e como reproduzir
- Release v2.135.0 (07/10/2026): github.com/docling-project/docling/releases/tag/v2.135.0
- PR da tabela Markdown de entrada: docling-project/docling#4488
- Repositório e licença: github.com/docling-project/docling
- Uso offline e TableFormer: documentação, advanced options
- Relatório técnico: Docling Technical Report, arXiv:2408.09869, doi.org/10.48550/arXiv.2408.09869
Pra reproduzir: Python 3.11, duas venvs (docling==2.134.0 e docling==2.135.0), gere o DOCX com python-docx e o .md com a tabela acima, rode os comandos deste post e compare com diff. Todos os dados são sintéticos.
In English
I ran Docling 2.135.0 on a synthetic lab report. DOCX and XLSX converted to clean Markdown tables in under 0.1 s with no model download, keeping bold on out-of-range values. The PDF pipeline failed because layout and table models could not be downloaded in my environment. The v2.135.0 table change (#4488) is about reading Markdown input: bold, code and links inside table cells are now kept, where 2.134.0 dropped them.
Última revisão em 07/10/2026.