Fala pessoal,
A RNDS só conversa em FHIR. Quem integra sistema de saúde no Brasil já pensou no atalho: pedir pra IA montar o Bundle direto da nota clínica. Ou passar a mensagem HL7 v2 antiga num conversor e mandar o resultado.
Eu rodei os dois caminhos e passei tudo na mesma régua. Dos 90 Bundles gerados por IA, 0 passaram no validador oficial da HL7. A resposta curta:
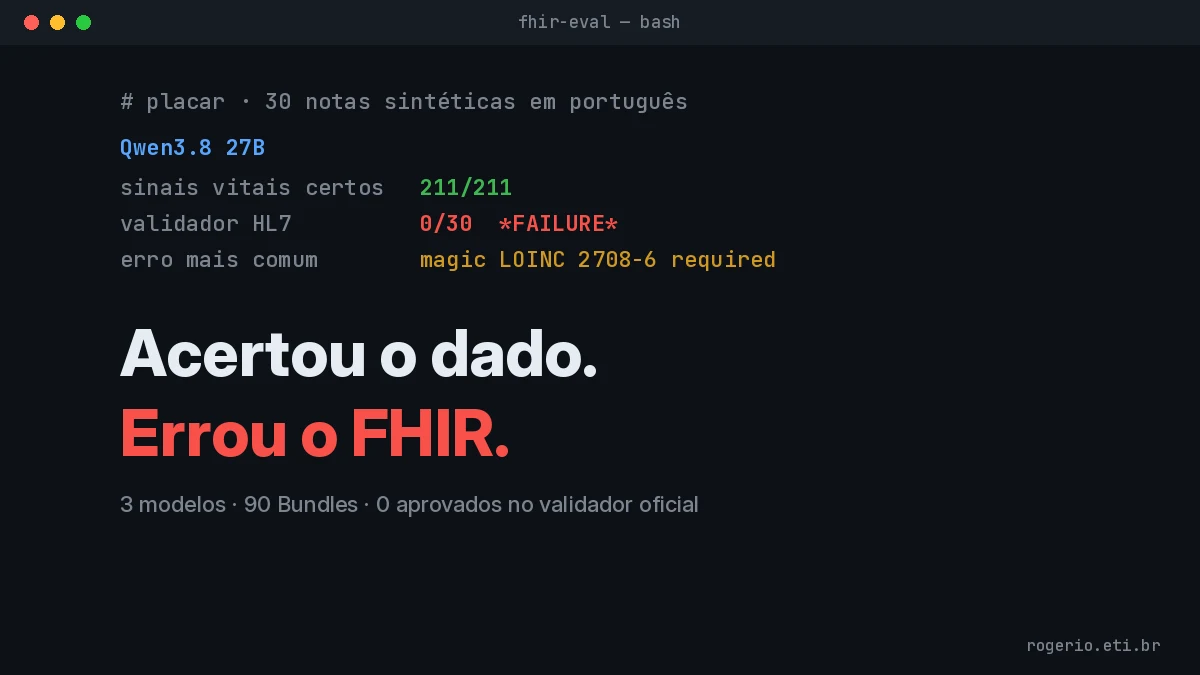
- Os dois modelos maiores acertam o conteúdo e erram a forma. O Qwen3.8 27B acertou 211 de 211 sinais vitais (valor, código LOINC e unidade). O validador oficial da HL7 reprovou 30 de 30 Bundles dele. Somando os três modelos, foram 90 Bundles e 0 aprovados.
- O conversor acerta a forma e erra o conteúdo. O hl7gen 0.2.0 saiu com 0 de 100 aprovados. Depois que acrescentei uma linha (o
fullUrlde cada entrada), passou pra 100 de 100. Mas nenhuma das 250 Observations e Encounters aponta pro paciente. - Uma rodada de conserto muda o placar. Devolvendo ao modelo os erros do validador, uma vez só, o gpt-oss-120b foi de 0 pra 11 aprovados nas 16 notas em que a rodada coube. O Qwen foi pra 6 de 9.
Passar no validador não quer dizer que o dado serve. E dado certo que não passa no validador não entra na RNDS. Precisa das duas réguas.
O que exatamente eu medi?
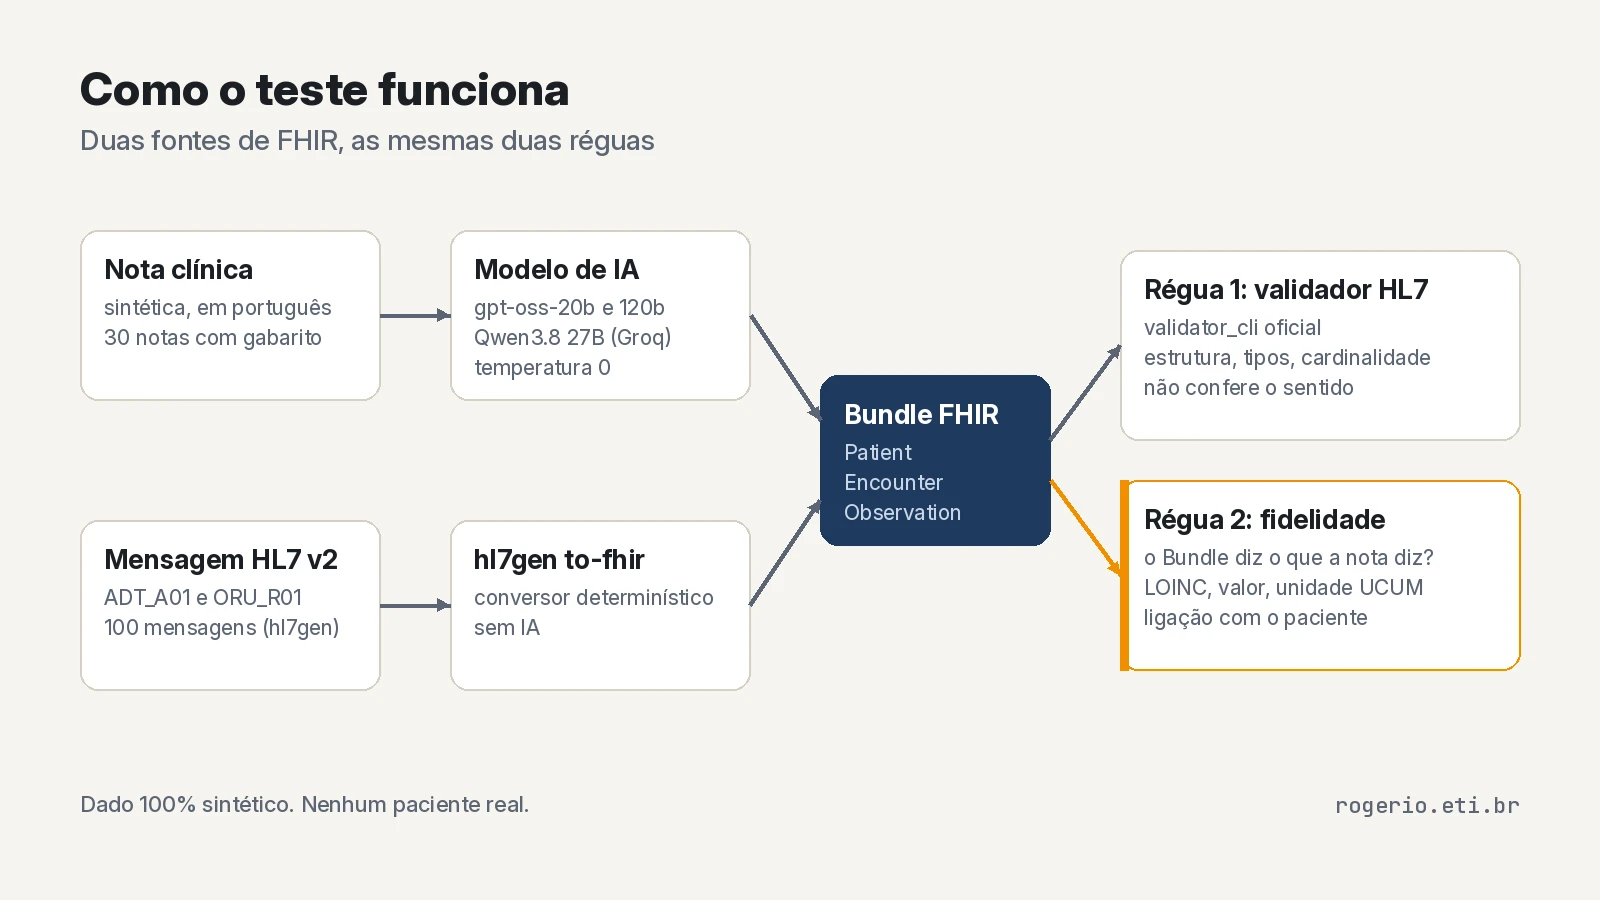
Duas fontes de FHIR, as mesmas duas réguas.
Fonte 1, IA. 30 notas clínicas sintéticas em português (nome inventado, CNS fictício, sinais vitais sorteados), cada uma com gabarito. Três modelos abertos no Groq, todos com o mesmo prompt congelado e temperatura 0: gpt-oss-20b, gpt-oss-120b e Qwen3.8 27B. O prompt pede um Bundle FHIR R4 com Patient, Encounter e uma Observation por sinal vital, com LOINC e UCUM.
Fonte 2, conversor. 100 mensagens HL7 v2 sintéticas (50 ADT_A01, 50 ORU_R01) geradas e convertidas pelo hl7gen 0.2.0, sem IA no meio.
Régua 1, o validador oficial. O validator_cli da HL7 (versão 6.3.11), o mesmo motor que o pessoal do FHIR usa pra validar Implementation Guide. Ele confere estrutura, tipo, cardinalidade e os perfis do core. Não confere se o dado bate com a nota.
Régua 2, fidelidade. Um script meu que compara cada Bundle com o gabarito da nota: o sinal vital está lá, com o código LOINC certo, o valor certo e a unidade UCUM certa? A Observation aponta pro paciente?
O prompt, literal:
Você é um sistema de integração hospitalar. Converta a nota clínica abaixo em um único
Bundle FHIR R4 em JSON (type "collection") com:
- 1 Patient (nome, sexo, data de nascimento, identificador CNS com system
  "https://saude.gov.br/fhir/sid/cns");
- 1 Encounter ambulatorial ligado ao Patient, com a data do atendimento;
- 1 Observation por sinal vital medido na nota, ligada ao Patient e ao Encounter, com código LOINC
  e unidade UCUM. Pressão arterial vai numa Observation só, com componentes sistólica e diastólica.
Responda APENAS com o JSON, sem texto antes ou depois e sem bloco de código.

Nota clínica:
<nota clínica sintética>
O placar
| Fonte | JSON lido | Passa no validador | Ligado ao paciente | Sinais vitais certos | Válido e fiel |
|---|---|---|---|---|---|
| hl7gen 0.2.0, como sai | 100/100 | 0/100 | 0/250 | sem gabarito | n/a |
| hl7gen 0.2.0 + fullUrl | 100/100 | 100/100 | 0/250 | sem gabarito | n/a |
| gpt-oss-20b | 17/30 | 0/30 | 118/118 | 101/211 | 0/30 |
| gpt-oss-120b | 30/30 | 0/30 | 211/211 | 206/211 | 0/30 |
| Qwen3.8 27B | 30/30 | 0/30 | 211/211 | 211/211 | 0/30 |
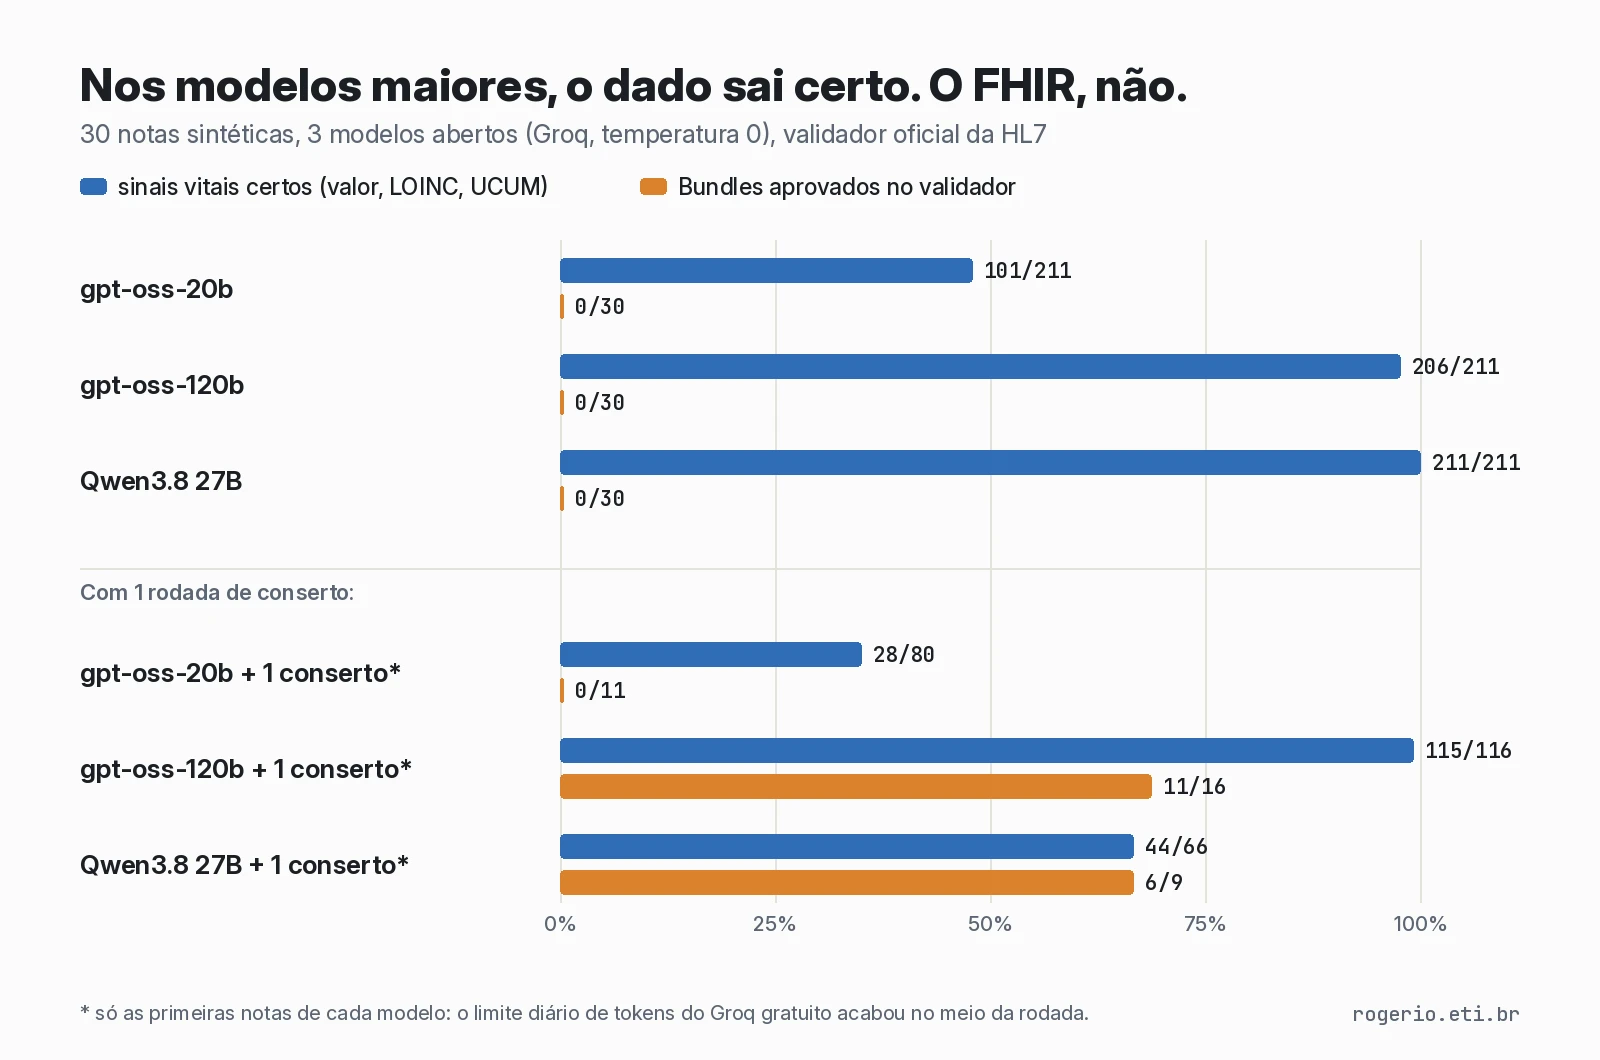
“Válido e fiel” é o único número que importa pra integração: passou no validador E disse o que a nota diz. Na geração direta, ficou em zero pra todo mundo.
O que o validador pegou?
Quatro erros explicam quase tudo.
1. Saturação sem o código que o perfil exige. 59 dos 60 Bundles do gpt-oss-120b e do Qwen caíram aqui. Os dois codificaram a SpO2 com o LOINC 59408-5 (oximetria de pulso), que é um código correto. Só que o perfil de sinais vitais do core FHIR exige também o 2708-6 na mesma Observation. O validador avisa sem rodeio:
Error @ Bundle.entry[6].resource/*Observation/obs-spo2*/.code
OxygenSatCode: magic LOINC code 2708-6 required, but not found
(from http://hl7.org/fhir/StructureDefinition/oxygensat|4.3.0).
Note that other Observation codes are allowed in addition to this required magic code
O conserto é uma linha a mais no coding:
{
  "code": {
    "coding": [
      {
        "system": "http://loinc.org",
        "code": "2708-6",
        "display": "Oxygen saturation in Arterial blood"
      },
      {
        "system": "http://loinc.org",
        "code": "59408-5",
        "display": "Oxygen saturation in Arterial blood by Pulse oximetry"
      }
    ]
  }
}
Eu também não lembraria desse detalhe de cabeça. O modelo não tem como adivinhar essa regra; o validador pega.
2. fullUrl que não é UUID. Os modelos escrevem urn:uuid:patient-001. Parece UUID, mas não é. O validador recusa: UUIDs must be valid and lowercase (patient-001). Apareceu nos 30 Bundles do Qwen.
3. Bundle sem fullUrl. O mesmo erro do hl7gen, e também de 13 dos 17 Bundles legíveis do gpt-oss-20b. Num Bundle do tipo collection, toda entrada precisa de fullUrl. É a identidade do recurso dentro do pacote.
4. Unidade inventada. O gpt-oss-20b escreveu beats/min, breaths/min, bpm, irpm e 1/min como código UCUM em 9 dos 17 Bundles legíveis (e o 120b, em 2). O valor estava certo, 93 é 93. Mas o perfil de sinais vitais fixa o código em /min, e o validador acusa: Value is 'beats/min' but must be '/min'. (O 1/min até é UCUM válido, só não é o que o perfil pede.)
// o que o gpt-oss-20b escreveu (nota-007)
"valueQuantity": {"value": 93, "unit": "beats/min",
                  "system": "http://unitsofmeasure.org", "code": "beats/min"}

// o que o perfil exige: code "/min"
"valueQuantity": {"value": 93, "unit": "beats/minute",
                  "system": "http://unitsofmeasure.org", "code": "/min"}
O que o validador não pega?
Tudo abaixo passa quieto no validador (sem servidor de terminologia, como rodei aqui).
Observation que não aponta pro paciente. É o caso do hl7gen: 0 de 250 referências. Você recebe um Bundle “válido” com Observations que não são de ninguém, e com código aleatório sem system. Na régua 1, nem erro dá. Vira um aviso de boa prática (all observations should have a subject), perdido no meio dos outros avisos.
Horário que ninguém mediu. A nota diz só a data do atendimento. O Qwen preencheu a hora como T00:00:00Z (por exemplo, 2026-10-03T00:00:00Z) em 24 dos 30 Bundles. Meia-noite em UTC é 21h do dia anterior em Brasília. O registro muda de dia e o validador acha ótimo.
Código certo da coisa errada. Em 2 Bundles o gpt-oss-120b codificou a glicemia capilar (mg/dL) com o LOINC 14749-6, que é glicose em mmol/L no soro. A unidade diz mg/dL e o código diz outra medida.
E quando o agente devolve o erro pro modelo?
O agente do teste faz isto: gerar, validar, devolver a lista de erros pro modelo e validar de novo. Uma rodada só, sem eu tocar no JSON.
# src/repair.py (trecho simplificado): uma rodada, sem mexer no JSON à mão
erros = sorted({m for s, m in val.get(src.name, []) if is_error(s, m)})
if not erros:          # já passou no validador: não gasta chamada
    dest.write_text(src.read_text()); continue
prompt = REPAIR.format(nota=note["texto"],
                       erros="\n".join(f"- {e}" for e in erros[:25]),
                       bundle=src.read_text())
text, _ = call(model, prompt, max_tokens=budget)
dest.write_text(extract_json(text))   # só se o JSON for válido; quebrado conta como falha
Resultado da rodada de conserto:
| Modelo (notas da rodada) | JSON lido | Passa no validador | Sinais vitais certos | Válido e fiel |
|---|---|---|---|---|
| gpt-oss-20b (11) | 4/11 | 0/11 | 28/80 | 0/11 |
| gpt-oss-120b (16) | 16/16 | 11/16 | 115/116 | 10/16 |
| Qwen3.8 27B (9) | 6/9 | 6/9 | 44/66 | 6/9 |
O gpt-oss-120b passou 11 dos 16 Bundles e manteve 115 de 116 sinais vitais certos: consertar a forma não estragou o conteúdo. O Qwen passou os 6 Bundles que voltaram inteiros. Os outros 3 saíram cortados, e aí a culpa é minha: pra caber no limite do Groq gratuito eu baixei o teto de tokens da resposta, e o JSON terminou no meio. O gpt-oss-20b não aprovou nenhum. Dos 11 que tentou, 7 voltaram com o JSON quebrado: 6 já vinham assim e 1, que estava legível, quebrou no conserto.
Ficou um asterisco grande: a rodada parou no meio porque o limite diário de tokens do Groq gratuito acabou (200 mil por dia por modelo). Por isso é 16, 9 e 11 notas, não 30. Rodar as 30 é o primeiro item da próxima versão do repo.
O que não funcionou?
Confesso que boa parte do tempo foi brigando com o ambiente, não com o FHIR.
- O registro de pacotes da HL7 estava bloqueado na máquina onde rodei. O validador baixa os pacotes do core sozinho, e aqui não conseguiu. Instalei pelo npm (pacotes publicados pelo Grahame Grieve). O
hl7.fhir.r4.coreno npm é um pacote vazio de segurança, então validei contra o R4B (4.3.0), não contra o R4. Pra Patient, Encounter e Observation as regras usadas aqui são as mesmas, mas é uma troca e fica dita. No repo, quem tem rede valida em R4 comtools/validate.sh <pasta> <saida> 4.0.1. - Sem servidor de terminologia. Rodei com
-tx n/a. O validador não confere se o código LOINC existe, e acusa erro quando não consegue checar um binding obrigatório de UCUM. Esses erros (39 no Qwen, 39 no 120b, 21 no 20b) são do ambiente, não do modelo, e ficaram fora da conta. - O validador novo estourou a memória. A versão 7.0.2 morreu com 6 GB. Voltei pra 6.3.11.
- O gpt-oss-20b quebrou o JSON em 13 de 30 notas. Fecha chave no lugar errado, no meio do Bundle. O parser não lê e acabou.
- Limite de 8 mil tokens por minuto no Groq gratuito. A rodada de conserto do Qwen andou devagar por causa disso.
Quando não usar esse resultado
- n = 30 notas, 3 modelos, 1 prompt. Serve pra mostrar o padrão de erro, não pra ranquear modelo. Outro prompt (por exemplo, colando o perfil de SpO2 no prompt) muda o placar.
- Nota sintética é mais limpa que nota real. Nota real tem abreviação, erro de digitação e sinal vital escrito de dez jeitos. A fidelidade tende a cair.
- Não validei contra os perfis da RNDS. Esse é o próximo passo, e é onde fica o “padrão do Ministério”. O validador oficial já roda os perfis; falta carregar o pacote.
- A régua 2 é minha. Ela confere 8 sinais vitais e a ligação com o paciente. Não confere nome, sexo, CNS nem data.
Fonte e como reproduzir
Repositório: github.com/rogeriorrodrigues/fhir-eval (MIT). Tudo sintético: notas, mensagens HL7 v2 e Bundles.
git clone https://github.com/rogeriorrodrigues/fhir-eval && cd fhir-eval
pip install -r requirements.txt
pytest -q -s tests                       # roda sem rede e sem modelo

# validador oficial da HL7 (Java 17+)
curl -L -o tools/validator_6.3.11.jar \
  https://github.com/hapifhir/org.hl7.fhir.core/releases/download/6.3.11/validator_cli.jar

# gerar com o seu modelo (Groq, Ollama ou qualquer API no formato da OpenAI)
cp .env.example .env && set -a && . ./.env && set +a
python3 src/generate.py data/notes.jsonl out/llm/meu-modelo
tools/validate.sh out/llm/meu-modelo out/llm-meu-modelo-oo.json 4.0.1   # R4
python3 src/semantic.py data/notes.jsonl out/llm/meu-modelo- Validador oficial: hapifhir/org.hl7.fhir.core 6.3.11
- Perfil de saturação de oxigênio no core: hl7.org/fhir/R4/oxygensat.html
- Conversor: mwaseem75/hl7gen, versão 0.2.0 no PyPI
- Modelos: gpt-oss-20b, gpt-oss-120b e qwen3.8-27b pela API do Groq, temperatura 0, rodados em 16/10/2026
E vocês, já colocaram IA pra gerar FHIR em produção? Que régua usam além do validador? Quero ler vocês nos comentários.
Summary in English
I asked three open models (gpt-oss-20b, gpt-oss-120b, Qwen3.8 27B) to turn 30 synthetic Portuguese clinical notes into FHIR R4 Bundles, and converted 100 synthetic HL7 v2 messages with hl7gen 0.2.0. The official HL7 validator passed none of the 90 model Bundles (13 were not even valid JSON), mostly for the missing 2708-6 code in the oxygen saturation profile and invalid urn:uuid fullUrls, even when the clinical content was right (Qwen: 211/211 vital signs correct). hl7gen passed after adding fullUrl, but none of its 250 Observations or Encounters references the patient. One repair round feeding validator errors back to the model took gpt-oss-120b from 0 to 11 of 16 valid (the free-tier daily token cap stopped the round halfway). Validation ran against R4B 4.3.0 without a terminology server; code and data at github.com/rogeriorrodrigues/fhir-eval.
Publicado em 16/10/2026. Última revisão: 16/10/2026.