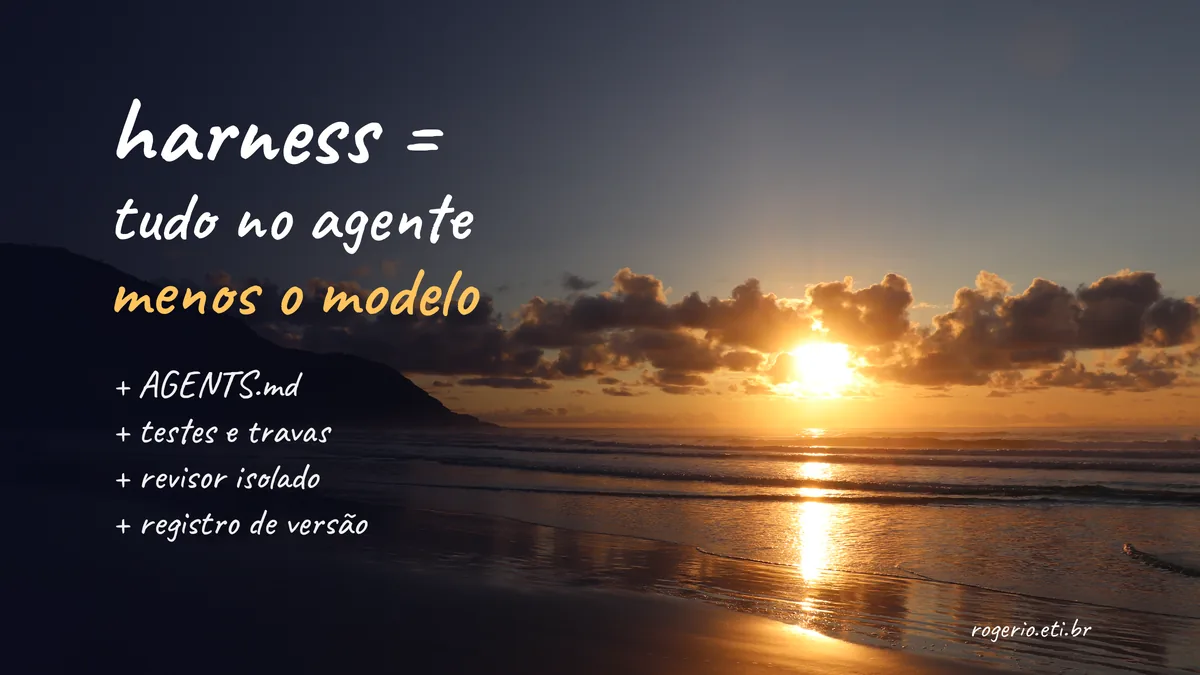
A definição que pegou, e que a Birgitta Böckeler, da Thoughtworks, usa no artigo “Harness engineering for coding agent users” (02/04/2026, martinfowler.com), é esta: harness é tudo num agente de IA menos o modelo. Na prática, eu aplico assim: um AGENTS.md com regras que o agente lê antes de mexer, testes e travas em código que param o agente sem pedir opinião, um revisor isolado, sem acesso à conversa, que lê o que o primeiro fez, e um registro que guarda a versão do harness junto com a do modelo. A lição mais cara veio de um erro meu: aviso escrito numa página avisa o humano. O agente passa por cima.
O que é harness engineering, segundo a Böckeler
O artigo parte de uma conta simples: agente = modelo + harness. O modelo você não controla. O harness externo, aquele que você monta pro seu repositório, você controla inteiro.
Ela divide os controles em dois tipos:
- Guias (feedforward): agem antes. Tentam evitar o erro. Exemplos dela: AGENTS.md, skills, documentação de referência, scripts de bootstrap.
- Sensores (feedback): agem depois. Observam o resultado e deixam o agente se corrigir. Exemplos: linters, testes estruturais, checagem de cobertura, agentes revisores.
E cada controle pode ser computacional (determinístico e rápido, como teste e linter) ou inferencial (análise semântica, revisão por IA, “LLM as judge”, mais lento e não determinístico).
A frase que mais uso do artigo é esta: separados, você ganha “an agent that keeps repeating the same mistakes (feedback-only) or an agent that encodes rules but never finds out whether they worked (feed-forward-only)”. Só sensor, o agente repete o erro. Só guia, ele segue regra sem saber se deu certo.
Guias: o que o agente lê antes de mexer
No projeto NursIA (PPGINFOS/UFSC, bolsa FAPESC), o repositório público de provas é o nursia-research-lab. A demo 06 compara quatro anonimizadores em 200 notas clínicas sintéticas em português. O resultado está no post A IA achou o CPF. E o CPF vazou mesmo assim. Aqui interessa outra coisa: como o agente que mexe nessa pasta é contido.
A pasta tem um AGENTS.md. Este é o trecho das regras, copiado do repositório:
Rules for anyone (human or agent) editing this folder:
- All data is synthetic by construction (seed 2026). Never add real
  patient data. CPF and CNS are generated by check digit, not copied.
- The prompt is frozen. prompts/extracao_v1.txt was written before any
  model ran and must not be edited. A change is a new file (extracao_v2.txt)
  and both versions go in the README.
- Do not swap models. If a tag in .env is missing from `ollama list` or does
  not fit in RAM, run_llms.py stops. Changing the model changes the post.
  Only models that fit this machine (36 GB) are in scope: Qwen 27B and Phi.
- Do not log note text outside results/. Raw model output lives only there.
- presidio_br comes from demos/04-presidio-br by relative import (demo04.py).
  Do not copy or rewrite the recognizers here.
- Every code file stays under 150 lines.
Repare no tipo de regra. Nenhuma diz “escreva código bom”. Cada uma fecha uma porta que um agente abre sem perguntar: editar o prompt depois de ver o resultado, trocar o modelo porque o outro não baixou, copiar código em vez de importar.
No sistema de conteúdo, o guia equivalente é o “Contrato do Second Brain”, uma página no Notion que toda task agendada e toda sessão lê antes de escrever. São regras curtas: escreva por ID e nunca por nome, confira a zona de arquivo antes de gravar, pauta vira linha no banco e não parágrafo, título sempre com data.
Sensores computacionais: o que para o agente sem discutir
Guia é pedido. Sensor é trava. A regra “não troque de modelo” do AGENTS.md tem um par em código, no run_llms.py:
def verificar_modelo(tag: str, maquina: dict) -> dict:
    """Para se o modelo não está no `ollama list` ou é maior que a RAM. Não troca de modelo."""
    modelos = requests.get(f"{HOST}/api/tags", timeout=10).json().get("models", [])
    m = next((m for m in modelos if tag in (m.get("name"), m.get("model"))), None)
    if m is None:
        sys.exit(f"PARE: {tag} não está no `ollama list` em {HOST}. Puxe com `ollama pull {tag}` "
                 "ou ajuste a tag no .env. Trocar o modelo muda o post, então não troco sozinho.")
    if maquina["ram_gb"] and m["size"] / 2**30 > maquina["ram_gb"]:
        sys.exit(f"PARE: {tag} tem {m['size'] / 2**30:.0f} GB e a máquina tem {maquina['ram_gb']} GB de RAM.")
O agente pode ignorar o AGENTS.md. Não tem como ignorar o sys.exit.
O mesmo vale pro corpus. O teste confere que as 200 notas saem sempre iguais, pelo hash:
def test_corpus_deterministico_mesma_seed_mesmo_hash():
    notas = corpus.gerar_corpus()
    assert len(notas) == 200
    assert corpus.hash_corpus(notas) == HASH_ESPERADO
    assert corpus.hash_corpus(corpus.gerar_corpus()) == HASH_ESPERADO
Outros testes da pasta checam que todo CPF e CNS do corpus passa no dígito verificador e que resposta que não é JSON conta como zero, e não como acerto. Tudo roda no GitHub Actions a cada push na pasta da demo (.github/workflows/demo-06-anonimizacao-pt.yml, Python 3.11, python3 -m pytest tests -q -s -rs). É o “keep quality left” do artigo: o sensor barato roda cedo e sempre.
No Notion, o sensor mais simples que adotei é a regra “leia de volta”: depois de gravar, a task busca o que gravou e confere. Sem leitura de volta, a tarefa não terminou. Por cima disso roda uma task de auditoria todo dia de manhã, o Curador, que confere se cada task rodou e se o que ela gerou existe. O contrato tem uma frase pra isso: configurado não é funcionando.
Sensor inferencial: o revisor adversarial
Teste não pega frase sem fonte num texto. Pra isso uso um sensor inferencial, que chamei de revisor adversarial. São dois revisores isolados, sem acesso à conversa que gerou a peça, com rubrica objetiva e até três rodadas. O veredito vai pra duas colunas do banco de pautas: Revisão (aprovada, conserta, mata ou escalada) e Falhas da revisão.
Dois exemplos reais, registrados no Notion:
- Num roteiro de reel sobre agentes, a primeira rodada marcou FATO numa legenda que dizia que o revisor “revisa cada mudança antes de aplicar”. Não havia fonte pra isso. A frase saiu.
- Nas peças de 07/10, três rodadas com seis revisores novos corrigiram “200 de 200”. O número só vale como “sem a marca certa”, porque em 26 notas um CPF saiu marcado como telefone.
Por que outro revisor, e não o mesmo agente se revisando? O paper de Huang e colegas (ICLR 2024, arXiv 2310.01798, “Large Language Models Cannot Self-Correct Reasoning Yet”) mostra que, sem sinal externo, o modelo corrigindo o próprio raciocínio não melhora com confiabilidade. É aluno corrigindo a própria prova.
Uso a mesma divisão em código. Na migração do NursIA pra AWS, um agente construiu e outro revisou. Os números dessa migração ainda não estão fechados, então não ponho aqui.
Registro: a versão do harness vai junto com a do modelo
Em 04/09 olhei pra trás e confirmei: desde maio, o que domina as mudanças no pipeline do NursIA é mudança de harness. Daí veio a regra. Toda avaliação registra a versão do harness junto com a do modelo. Na demo 06, cada rodada gera um .meta.json ao lado da saída bruta. Este é um trecho do arquivo do Qwen:
"tag": "qwen3.8:27b",
"digest": "22130167c4c20e20c7b71454612966ca8e8171e9b3cc8ab6ce8aa6cbfec79643",
"prompt": "extracao_v1.txt",
"opcoes": {"temperature": 0, "seed": 2026},
"ollama": "0.34.2",
Digest do modelo, versão do prompt, temperatura, seed e versão do Ollama. O arquivo completo guarda também a máquina e o horário de início e fim. Se um número mudar amanhã, dá pra saber se mudou o modelo ou o resto.
No sistema de conteúdo, o registro é o banco Diário de sessões. Toda sessão de trabalho com agente cria uma linha logo na primeira entrega, atualiza a cada entrega e fecha no fim. Uma varredura diária cria a linha das conversas que ficaram sem registro.
O que não funcionou
Em 19/09 reorganizei o Second Brain inteiro. Em 21/09, 48 horas depois, já tinha degradado. O radar criou título com data invertida. O garimpo escreveu 19 pautas em prosa sem criar nenhuma linha no banco. O planejador gravou o plano na página que a reforma tinha acabado de aposentar, mesmo com o carimbo avisando isso nela.
O diagnóstico daquele dia virou a frase do contrato: carimbo na página avisa o humano, não segura o agente. Eu tinha guia e nenhum sensor. Foi exatamente o caso “feed-forward-only” da Böckeler.
O sensor inferencial também tem limite. Nas peças de 07/10, a revisão terminou “escalada” depois de três rodadas. O revisor não fecha sozinho. A decisão volta pra mim. A própria Böckeler admite o problema maior: o harness de comportamento, que diz se o código faz o que devia, ainda depende de teste gerado por IA, e ela escreve que isso “not good enough yet”.
Quando não usar
- Script de uso único. Escrever AGENTS.md, teste e revisor pra algo que roda uma vez custa mais que corrigir na mão.
- Tarefa sem erro repetido. O harness cresce do erro que volta. Sem histórico de erro, você está adivinhando regra.
- Revisor inferencial em tudo. Ele gasta token e tempo e não é determinístico. Onde dá pra testar com código, teste com código.
- Quando você não vai ler o resultado do sensor. Sensor que ninguém olha é o mesmo carimbo de 21/09, com outro nome.
Fonte e como reproduzir
- Artigo: Birgitta Böckeler, Harness engineering for coding agent users, martinfowler.com, 02/04/2026 (memo inicial em 17/02/2026).
- Repositório: nursia-research-lab/demos/06-anonimizacao-pt. Arquivos citados:
AGENTS.md,run_llms.py,tests/test_corpus.py,results/raw/ollama_qwen.meta.jsone.github/workflows/demo-06-anonimizacao-pt.yml. - Paper: Huang et al., Large Language Models Cannot Self-Correct Reasoning Yet, ICLR 2024, arXiv 2310.01798.
Os sensores computacionais rodam sem Ollama, com os comandos do próprio AGENTS.md:
cd demos/06-anonimizacao-pt
pip install -r requirements.txt
python3 -m pytest tests -q -s -rs
In English
Birgitta Böckeler (Thoughtworks) defines the harness as everything in a coding agent except the model, split into guides (before) and sensors (after). I apply it with an AGENTS.md, hard stops and tests in CI, an isolated adversarial reviewer, and run metadata that records the harness version next to the model version. My failure: a warning on a page told the human, it didn’t stop the agent.
Última revisão em 07/10/2026.