Peguei 4 ferramentas pequenas (validar CPF, validar CNS, mascarar e contar identificadores) e servi o mesmo código de três jeitos: como servidor MCP, como função de API escrita à mão e como Skill. Depois contei quantos tokens cada jeito põe na janela de contexto do modelo. Sem chamar modelo nenhum, só montando o que vai no pedido.
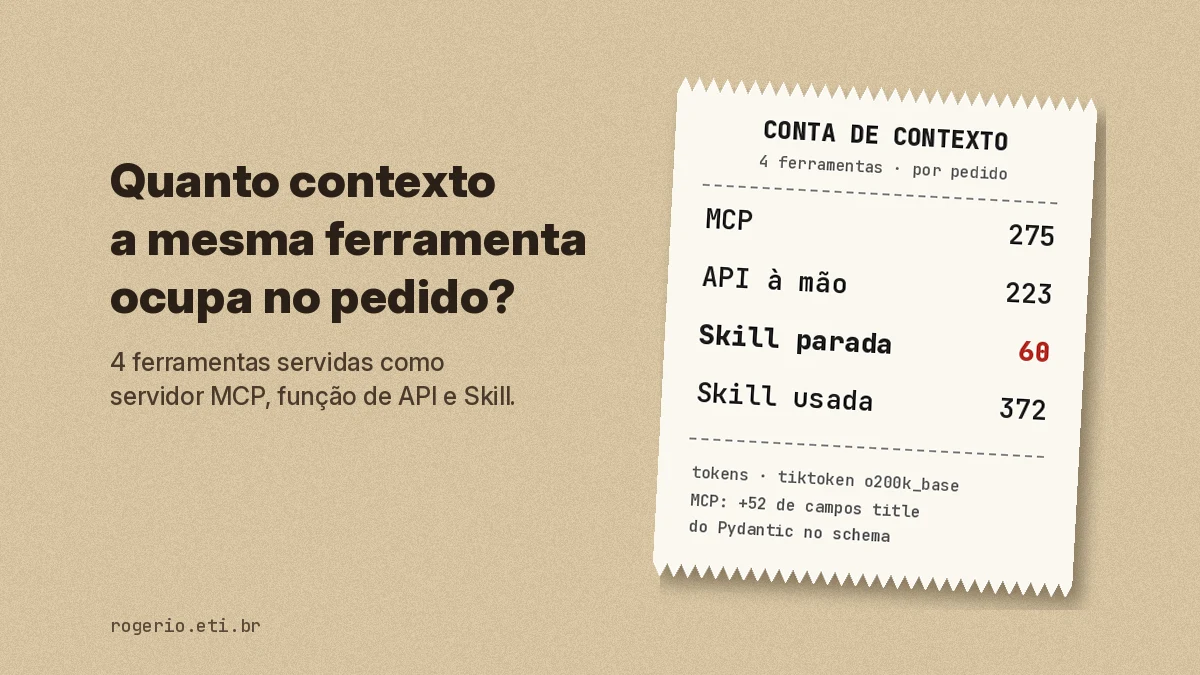
Resultado com o tokenizador o200k_base: como MCP, as 4 ferramentas custam 275 tokens em todo pedido. Como função de API, 223. Como Skill parada, 60. Quando a Skill é usada, o corpo do SKILL.md entra no contexto e a conta vai pra 372.
Código, saída gravada e teste: demos/13-mcp-skill-api-contexto, no nursia-research-lab.
Por que medir contexto, e não acerto?
A pergunta “MCP, Skill ou chamada de API?” aparece toda semana. A resposta costuma vir em tabela de prós e contras, sem número. Eu queria começar pelo que dá pra medir sem gastar um centavo de API: o espaço que cada via ocupa antes de o modelo fazer qualquer coisa.
Contexto é dinheiro e é atenção. Toda definição de ferramenta vai junto em todo pedido. Em muitos hosts, um agente com vários servidores MCP ligados carrega as ferramentas de todos na janela, use ou não use. A Skill promete o contrário: na documentação de Agent Skills, o carregamento tem três níveis. O nome e a descrição entram sempre (“~100 tokens per Skill”). O corpo do SKILL.md entra quando a Skill dispara. Scripts rodam pelo shell e só a saída entra.
Pensa num restaurante. O MCP e a função de API são o cardápio inteiro na mesa desde que você senta. A Skill é o garçom que diz “tem peixe hoje” e só traz o cardápio do peixe se você pedir.
Como rodei
- Python 3.11, num venv limpo.
mcp==2.3.0(SDK oficial do Model Context Protocol, licença MIT) etiktoken==0.14.0(MIT). CPU, sem chave de API, sem conta. - Via MCP: um
MCPServerde verdade, com as 4 funções registradas poradd_tool, e umClientem memória chamandotools/listetools/call. Medi a resposta inteira dotools/liste a parte que o host repassa pro modelo: nome, descrição e o JSON Schema de entrada. - Via API: as mesmas 4 definições escritas à mão no formato de tool use, com a mesma descrição de cada função.
- Via Skill: um
SKILL.mdcom frontmatter e corpo (tabela das ações, como chamar, 3 regras) e um script que o agente roda pelo shell. - Uma nota sintética com um CPF e um CNS gerados por algoritmo, e um CPF digitado errado de propósito. As três vias devolveram o mesmo texto mascarado, conferido com
assert.
O miolo da via MCP é curto:
from mcp.client import Client
from mcp.server.mcpserver import MCPServer

servidor = MCPServer("identificadores")
for f in ferramentas.FERRAMENTAS:
    servidor.add_tool(f)

async with Client(servidor) as cliente:
    lista = await cliente.list_tools()

pro_modelo = [
    {"name": t.name, "description": t.description, "input_schema": t.input_schema}
    for t in lista.tools
]
E o nível 1 da Skill, que é tudo que o modelo vê enquanto ela não é usada:
name: mascarar-identificadores
description: Valida, conta e mascara CPF e CNS (Cartão Nacional de Saúde) em texto livre. Use quando o usuário pedir pra checar um CPF ou CNS, contar identificadores numa nota ou tirar CPF e CNS de um texto antes de mandar pra outro sistema.
O que deu?
Saída de results/saida.txt, sem retoque:
| O que entra no contexto | o200k_base | cl100k_base |
|---|---|---|
Resposta inteira do tools/list (MCP) |
417 | 417 |
| Definições do MCP que vão pro modelo, por pedido | 275 | 283 |
| Definições escritas à mão pra API, por pedido | 223 | 231 |
| Skill, nível 1 (nome e descrição), por pedido | 60 | 66 |
Skill, nível 2 (corpo do SKILL.md), depois de usada |
312 | 337 |
| Código do script da Skill (não entra) | 103 | 109 |
| Uma chamada MCP ou API: argumentos + resultado | 61 + 43 | 65 + 47 |
| Uma chamada pela Skill: comando + saída | 17 + 44 | 18 + 47 |
Três leituras.
MCP e API são a mesma coisa vista de perto. O host pega a ferramenta do MCP e entrega ao modelo como uma definição de função. A diferença de 52 tokens (275 contra 223) não vem do protocolo. Vem de campos title que o Pydantic gera no JSON Schema: "title": "Cpf" em cada argumento e "title": "validar_cpfArguments" no objeto. Tirando esses campos, a definição do MCP ficou idêntica à que eu escrevi à mão (mcp_igual_api_sem_title: true no resultado.json). São 23% a mais de definição por pedido, só de rótulo que o modelo não precisa.
A Skill é barata parada e cara depois de usada. 60 tokens enquanto ninguém precisa dela, menos de um quarto do MCP. Mas o corpo do SKILL.md tem 312 tokens, e quando ele entra a Skill passa a custar 372. Mais que o MCP. O corpo é maior porque ele carrega o que a definição de função não tem: quando usar cada ação, e regras como “nunca repita o CPF original na resposta”.
A chamada em si custa parecido. Pela Skill, o comando é curto (17 tokens) porque o texto vai pelo stdin. Pelo MCP ou pela API, o texto vai dentro dos argumentos (61). A saída é praticamente igual nas duas (43 e 44).
E numa conversa inteira?
Projeção pra 10 pedidos ao modelo, supondo que a definição vai em todo pedido e que o corpo da Skill, depois de lido, fica no histórico até o fim:
| Cenário, 10 pedidos | Tokens de definição (o200k_base) |
|---|---|
| MCP | 2.750 |
| API escrita à mão | 2.230 |
| Skill usada já no 1º pedido | 3.720 |
| Skill usada só no 10º pedido | 912 |
| Skill nunca usada | 600 |
Fazendo a conta com os números da tabela: a Skill custa 600 de metadado nos 10 pedidos mais 312 por pedido a partir do primeiro uso. Ela fica abaixo dos 2.750 do MCP quando o primeiro uso acontece do 5º pedido em diante. Se a ferramenta é usada logo no começo, o MCP sai mais barato. Se é usada de vez em quando, a Skill ganha.
O que não funcionou
Duas coisas, ambas minhas.
A primeira: o código não subiu. Escrevi from mcp.server.fastmcp import FastMCP, do jeito que eu usava, e a versão 2.3.0 respondeu que o FastMCP virou MCPServer na linha 2.x do SDK. A mensagem de erro já apontava o guia de migração, o que ajudou. Quem tem servidor MCP em Python preso em mcp<2 vai bater nisso na próxima atualização.
A segunda: eu esperava que a definição do MCP fosse igual à da API. Pus um assert comparando as duas e ele falhou. Confesso que fui atrás de bug no meu código antes de olhar o JSON. O “bug” eram os title do Pydantic. Virou o achado da demo.
Onde a medida falha
- O tokenizador não é o do modelo que você usa. Os números são do tiktoken, com dois tokenizadores (
o200k_baseecl100k_base). Servem pra comparar as vias entre si. O valor absoluto muda de modelo pra modelo, e o tokenizador do Claude não roda offline. - A Skill precisa de shell. Ela só funciona se o agente tem uma ferramenta de shell ou de execução de código, e a definição dessa ferramenta também ocupa contexto. Não somei, porque depende do host. Se o seu agente não tem shell, a comparação nem se aplica.
- O host decide o que repassa. A demo mede o que o servidor MCP manda. Cada cliente (Claude Code, Copilot, Cursor, o seu) pode cortar o
title, ignorar ooutputSchemaou reescrever a descrição. - Contexto não é acerto. A demo mede só espaço ocupado. Se o modelo escolhe a ferramenta certa em cada via, e em quanto tempo, é a próxima rodada, com modelo de verdade.
- Cache de prompt muda a conta do dinheiro, não a do contexto. Definição que se repete em todo pedido costuma cair no cache do provedor e sair mais barata, mas continua ocupando a janela.
- 4 ferramentas pequenas. Com mais ferramentas, o fixo do MCP e da API cresce junto. O nível 1 da Skill cresce com o número de Skills, não com o de ações dentro de cada uma.
Qual eu escolheria?
O número não aponta um vencedor. Aponta quando cada via compensa.
- Ferramenta usada em quase todo pedido: MCP ou função de API. Se for MCP em Python, vale conferir o schema que sai do servidor. Os 52 tokens de
titledesta demo saíram de graça, sem eu pedir. - Ferramenta que aparece de vez em quando, com regra de uso que importa: Skill. O metadado é barato e as regras (“não repita o CPF”) vão junto quando precisam ir.
- Muitas ferramentas de vários fornecedores: MCP continua sendo o jeito de não reescrever integração. O custo de contexto é o preço disso, e dá pra reduzir desligando servidor que não está em uso.
O que custa implementar
- Skill exige ambiente com shell e Python (ou o que o script usar). Em API pura, sem execução de código, ela não roda.
- MCP exige um processo servidor e alguém que cuide da versão do SDK. A troca de FastMCP pra MCPServer mostra que a API do SDK ainda muda entre versões grandes.
- Função de API escrita à mão é a mais enxuta e a que mais dá trabalho manter: o schema fica longe do código e desatualiza sem avisar.
- Medir é barato. Os testes, que rodam a demo inteira, passam em 1,34 s. Vale rodar a mesma conta com as ferramentas do seu agente antes de decidir no achismo.
No seu agente, qual ferramenta fica carregada em todo pedido e quase nunca é usada?
Fonte e como reproduzir
Código, resultado e teste: github.com/rogeriorrodrigues/nursia-research-lab/tree/main/demos/13-mcp-skill-api-contexto (MIT).
pip install -r requirements.txt
python3 demo.py
python3 -m pytest tests -q -s
Na primeira execução o tiktoken baixa os arquivos dos dois tokenizadores e confere o hash deles. Fontes primárias: SDK Python do MCP (versão 2.3.0), documentação de Agent Skills (os três níveis de carregamento) e tiktoken (versão 0.14.0). Todo dado é sintético: o CPF e o CNS da nota são gerados por algoritmo e o nome é “FULANO DE TAL SINTETICO”.
English summary: The same 4 tools served as an MCP server, as hand-written API tool definitions and as an Agent Skill, with no model call. Counted with tiktoken o200k_base: MCP 275 tokens per request, API 223, idle Skill 60, Skill after use 372. The 52-token MCP overhead is Pydantic-generated title fields in the input schema; without them the MCP definition matches the hand-written one.
Demo publicada no repositório do NursIA (PPGINFOS/UFSC, bolsa FAPESC). Publicado em 10/11/2026.