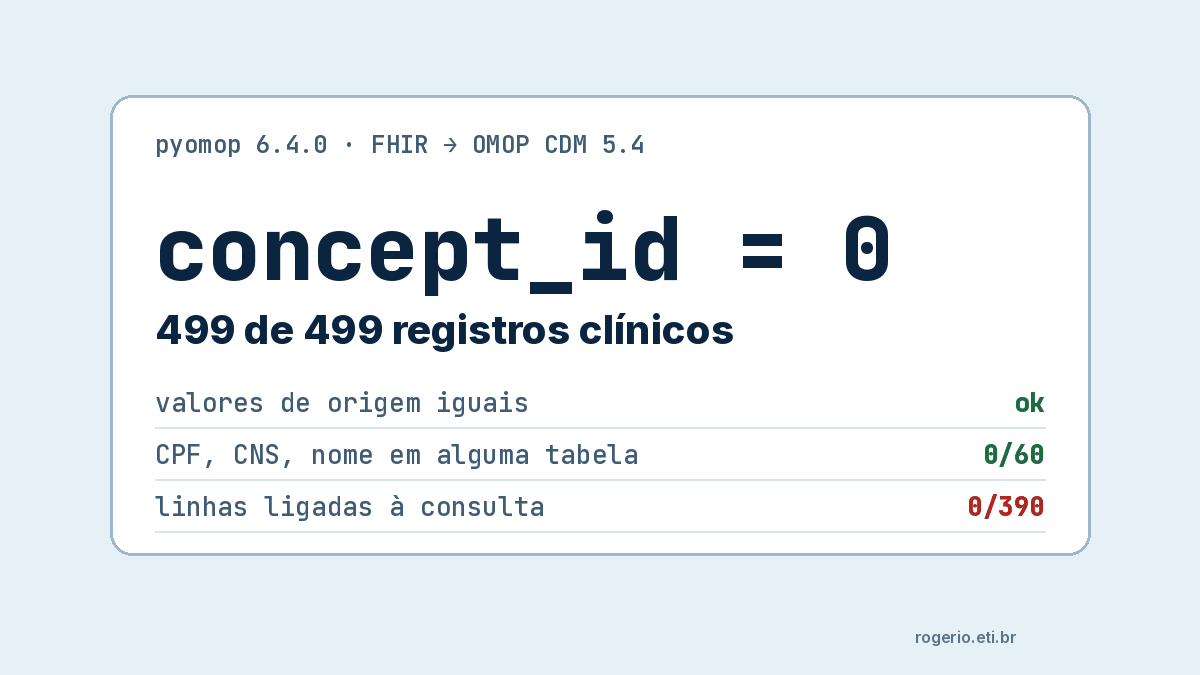
Rodei o pyomop 6.4.0 em 60 pacientes FHIR sintéticos, no comando mínimo, sem o vocabulário do OHDSI. O README do pacote manda passar --vocab; eu não passei, de propósito, para medir o que a carga entrega sem ele. Levou cerca de 4 segundos, já com a criação das tabelas, e os campos que conferi chegaram iguais. Mas as 499 linhas clínicas (em cinco tabelas) ficaram com concept_id em 0. Sem esse número, consultas por conceito deixam essas linhas de fora.
Código, dados e saída gravada: demos/10-pyomop-fhir-omop no nursia-research-lab.
Como rodei
- pyomop 6.4.0 (
pip install pyomop==6.4.0), Python 3.11, CPU, OMOP CDM 5.4 (modelo comum de dados) em SQLite. As versões das dependências estão fixadas norequirements.txt. - Gerei o FHIR em NDJSON (um JSON por linha), com semente fixa: 60 Patient, 109 Encounter, 90 Condition (CID-10), 120 Observation (LOINC 8867-4 e 8480-6) e 60 MedicationRequest (RxNorm).
- Cada paciente tem CPF e CNS no
identifier, além de nome, telefone e endereço inventados. CPF e CNS passam no dígito verificador, mas são sorteados e não pertencem a ninguém. - Condição, observação e prescrição apontam para uma consulta no campo
encounter. - Comando do pyomop:
pyomop --create --name cdm.sqlite --input fhir_sintetico. É o fluxo do README sem o--vocab. Depois, o script lê o banco e confere cinco coisas.
Não carreguei o vocabulário do OHDSI Athena, o repositório de vocabulários do OHDSI. O download exige conta e eu não fiz. Isso explica o resultado principal: o concept_id em 0 é o esperado para essa chamada, e não um defeito do pacote. Volto nisso nos limites.
O que chegou
| Recurso FHIR | No FHIR | Tabela OMOP (linhas) |
|---|---|---|
| Patient | 60 | person (60) |
| Encounter | 109 | visit_occurrence (109) |
| Condition | 90 | condition_occurrence (90) |
| Observation | 120 | measurement (120) e observation (120) |
| MedicationRequest | 60 | drug_exposure (60) |
Conferi seis grupos de campos de origem, e todos chegaram iguais: sexo em 60 de 60, nascimento em 60 de 60, medidas (código, valor e data) em 120 de 120, condições em 90 de 90, consultas (início, fim e classe) em 109 de 109 e medicamentos (código e data) em 60 de 60. Não conferi unidade, horário, data de fim da condição nem posologia.
O que o pyomop faz certo
A parte difícil de uma carga FHIR para OMOP é não perder nem trocar dado. Aqui nenhum registro sumiu: as contagens batem recurso a recurso, e as datas e os valores dos campos que conferi batem. O sexo foi convertido para o concept_id padrão (8507 para masculino, 8532 para feminino) sem consultar a tabela concept: o loader.py usa um mapeamento fixo no código. O person_id seguiu a ordem de carga, e o id do FHIR ficou em person_source_value, o que permite voltar ao recurso original.
A carga funcionou. O que falta é o vocabulário.
O que ficou pelo caminho
concept_id em 0
No OMOP, o concept_id é o que permite perguntar “todos os pacientes com hipertensão” sem listar códigos. Na carga, ele ficou em 0 em todas estas colunas:
| Coluna | Em 0 ou nulo |
|---|---|
| condition_concept_id | 90 de 90 |
| measurement_concept_id | 120 de 120 |
| unit_concept_id | 120 de 120 |
| observation_concept_id | 120 de 120 |
| drug_concept_id | 60 de 60 |
| visit_concept_id | 109 de 109 |
Qualquer consulta que filtre por conceito deixa esses registros de fora (não testei no ATLAS, a ferramenta de consulta do OHDSI). O código original ficou nas colunas *_source_value (por exemplo, I10 e 8867-4), então nada se perdeu. Raça e etnia também ficaram em 0 em 60 de 60, mas aí a entrada ajuda: meu Patient sintético não tem a extensão de raça e etnia. Só gender_concept_id veio preenchido, com 8507 e 8532. A tabela concept tinha 0 linhas.
Nenhuma linha clínica ligada à consulta
O visit_occurrence_id ficou vazio nas 390 linhas clínicas de condição, medida, observação e medicamento, apesar de o FHIR de entrada trazer o campo encounter. Abri o mapping.default.json do pacote: ele não mapeia visit_occurrence_id nem encounter. Ligar o evento à consulta exigiria um mapeamento próprio, que eu não testei, e não sei se o loader resolve: ele só tem passo de normalização de chave para person_id. No meu FHIR, todas as consultas são ambulatoriais e cada evento aponta para a primeira consulta do paciente.
Cada Observation entra em duas tabelas
As 120 Observation viraram 120 linhas em measurement e mais 120 em observation. O mapeamento padrão faz isso. Quem somar as duas tabelas conta cada observação duas vezes.
O dado pessoal não entrou
Procurei CPF, CNS, nome completo, sobrenome, telefone, rua e CEP em todas as células de todas as tabelas: 0 de 60 pacientes em cada um. O person_source_value guarda só o id do Patient (p001). O CPF não está no banco. Se você precisa ligar o registro ao paciente, mantenha a tabela de correspondência fora do OMOP. Isso vale para o mapeamento padrão com estes campos, e não é uma garantia de privacidade do pacote.
O que eu faria
- Antes de carregar dado real, rode a carga num FHIR sintético seu e conte as linhas com
concept_id = 0. - Carregue o vocabulário do Athena junto com a carga, como o README do pacote manda. Sem ele, todo
concept_idclínico fica em 0, foi o que medi. Carregar não garante acerto: pelo código, o passo de mapeamento busca só por igualdade deconcept_code, sem olhar o vocabulário de origem, e códigos iguais em vocabulários diferentes podem colidir. Não testei. - Se o seu caso precisa ligar evento e consulta, um mapeamento próprio é o caminho a investigar. Eu não testei.
Limites
- Sem vocabulário Athena. O pyomop tem um passo que preenche o
concept_idprocurando oconcept_codena tabelaconcept. Não rodei esse passo com vocabulário, então não sei quanto ele acerta. - 60 pacientes sintéticos, uma semente, cinco tipos de recurso, CDM 5.4, SQLite. Não testei PostgreSQL, CDM 6, Bundle em JSON (um arquivo com vários recursos) nem os recursos de LLM e MCP do pacote.
- Não testei um arquivo de mapeamento próprio.
- Medi a carga e a integridade dos valores. Não medi a qualidade clínica do mapeamento.
- O tempo de cerca de 4 segundos vale para esta máquina e para 60 pacientes. Não medi desempenho em volume maior.
Fonte e como reproduzir
Clone https://github.com/rogeriorrodrigues/nursia-research-lab e entre em demos/10-pyomop-fhir-omop. Daí são três comandos:
pip install -r requirements.txt
python3 demo.py
python3 -m pytest tests -q- Pasta no repositório: demos/10-pyomop-fhir-omop. Saída gravada em
results/. - pyomop: github.com/dermatologist/pyomop, versão 6.4.0. O LICENSE do repositório é GPL v3.
- OMOP CDM 5.4: ohdsi.github.io/CommonDataModel.
NursIA é pesquisa do PPGINFOS/UFSC, com bolsa FAPESC.
In English
I loaded 60 synthetic FHIR patients into OMOP CDM 5.4 with pyomop 6.4.0 in about 4 seconds. The source fields I checked arrived intact and no CPF, name or address landed in any table. But all 499 clinical rows (five tables, 379 FHIR resources) have concept_id = 0 without an Athena vocabulary, as expected without --vocab, none links to its visit, and each Observation is written to two tables.