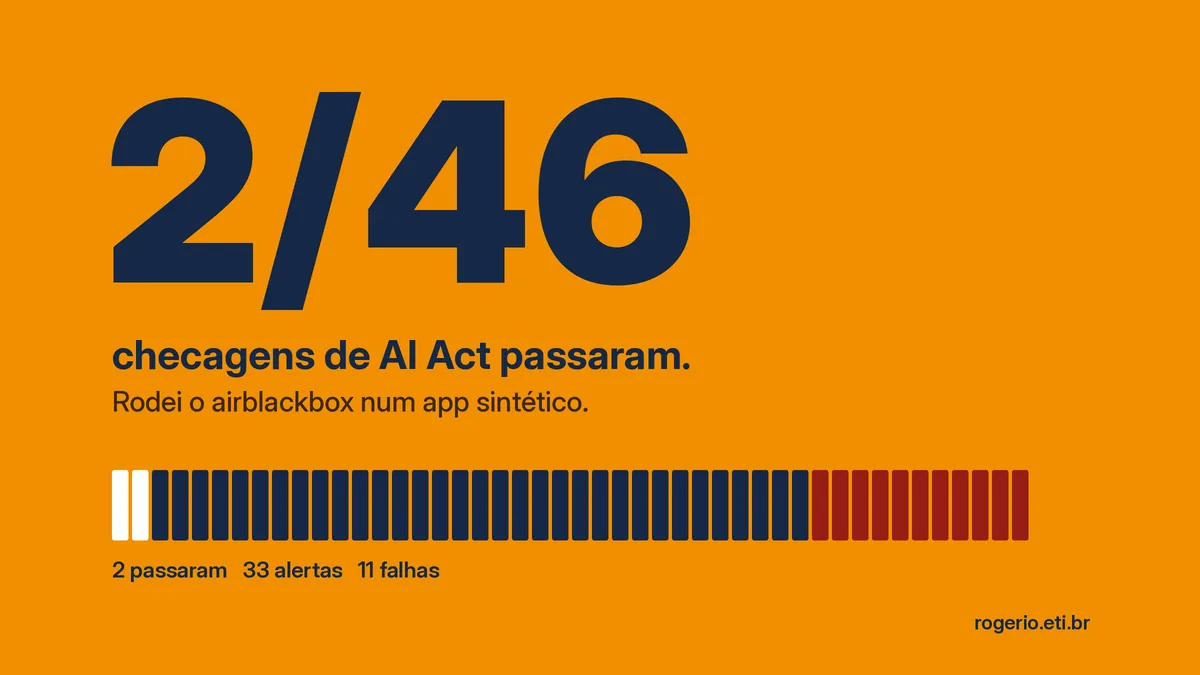
Rodei o airblackbox 1.16.0 em 07/10/2026 num app Python sintético que chama um LLM fictício e grava prompt e CPF inventado num arquivo de log. Resultado: 46 checagens no modo EU, 2 passaram, 33 deram alerta, 11 falharam. Depois criei três arquivos Markdown de uma linha cada. Três falhas viraram PASS. O scanner é útil pra achar buraco. Ele não prova conformidade com o AI Act, e o próprio README avisa isso.
O que é o airblackbox
É um projeto open source, licença Apache 2.0, publicado no PyPI como air-blackbox. Faz mais coisa do que o scanner: gateway que grava cada chamada de LLM numa trilha encadeada com HMAC, assinatura Ed25519, pacote de evidência, replay. Aqui eu testei só o scanner: air-blackbox comply, a análise de lacunas contra os artigos 9, 10, 11, 12, 14 e 15 do AI Act.
Muita gente repete 51 checagens. O README diz “51+”. Na minha execução, o modo --standard eu rodou 46: 38 ligadas aos artigos do AI Act e 8 de GDPR. Com --standard all entram 9 checagens de leis estaduais dos EUA e o total vai a 55. Então o número depende do modo e do projeto. Não repita “51” sem dizer de onde veio.
Um detalhe antes de adotar: o README diz que o projeto está estável e mantido, mas sem novas features. Correção de segurança entra. Integração nova, não.
Como rodei
Ambiente: Linux, Python 3.11.15, venv limpo. Instalação pela documentação oficial:
python3 -m venv venv
venv/bin/pip install air-blackbox
venv/bin/air-blackbox --version
# air-blackbox, version 1.16.0
O projeto de teste tem dois arquivos. Dado 100% inventado. O endpoint do LLM não existe, o scanner só lê código.
# app.py
"""Triagem sintetica: app minimo que chama um LLM ficticio e loga tudo.
Dados 100% inventados. Nenhum paciente real."""
import logging
from openai import OpenAI

logging.basicConfig(filename="triagem.log", level=logging.INFO)
log = logging.getLogger("triagem")

# endpoint ficticio, nunca responde de verdade
client = OpenAI(base_url="http://llm-ficticio.local/v1", api_key="sk-fake")

PACIENTE = {"nome": "Maria Teste", "cpf": "000.000.000-00", "queixa": "dor toracica"}


def classificar(paciente: dict) -> str:
    prompt = f"Classifique o risco: {paciente['nome']}, {paciente['queixa']}"
    log.info("prompt enviado: %s | cpf=%s", prompt, paciente["cpf"])
    resp = client.chat.completions.create(
        model="modelo-ficticio",
        messages=[{"role": "user", "content": prompt}],
    )
    texto = resp.choices[0].message.content
    log.info("resposta: %s", texto)
    return texto


if __name__ == "__main__":
    print(classificar(PACIENTE))
O requirements.txt tem uma linha: openai>=1.0. Rodei sem LLM local (o modo profundo usa Ollama) e sem salvar histórico:
air-blackbox comply --scan . -v --no-llm --no-save --standard euO que saiu
O resumo final da ferramenta:
2 passing  33 warnings  11 failing  out of 46 checks
  Static analysis:  2/33 passing  (code patterns, docs, config)
  Runtime checks:   0/13 passing  (requires gateway or trust layer)
Detection: 38 auto, 6 hybrid, 2 manual (96% automated)| Bloco | Checagens | Pass | Warn | Fail |
|---|---|---|---|---|
| Art. 9, gestão de risco | 4 | 0 | 1 | 3 |
| Art. 10, governança de dados | 5 | 0 | 3 | 2 |
| Art. 11, documentação técnica | 6 | 1 | 3 | 2 |
| Art. 12, registro de eventos | 7 | 1 | 4 | 2 |
| Art. 14, supervisão humana | 9 | 0 | 8 | 1 |
| Art. 15, precisão, robustez e cibersegurança | 7 | 0 | 6 | 1 |
| GDPR | 8 | 0 | 8 | 0 |
As falhas fazem sentido. Não tem tratamento de erro na chamada ao LLM. Não tem documento de risco. Não tem trilha à prova de adulteração. Não tem proteção contra prompt injection. Cada linha vem com uma dica de correção. Pra quem nunca abriu o texto do AI Act, essa lista já ensina o vocabulário.
13 das 46 checagens são de runtime e nenhuma passou porque eu não subi o gateway: 8 ficaram em alerta e 5 contam como falha. Quase metade das 11 falhas some ou aparece conforme você adota a infraestrutura do próprio projeto. A própria saída sugere instalar uma “trust layer” (air-openai-trust) pra liberar essas checagens. Ou seja: boa parte da nota depende de você adotar a infraestrutura do mesmo projeto.
Onde o resultado engana
Logar CPF em texto puro passou no artigo 12
A checagem “Application logging” deu PASS: “Logging found in 1/1 files (100%)”. O log que ela aprovou grava nome e CPF do paciente em texto puro. A checagem de PII no código deu só WARN genérico (“No PII detection, redaction, or masking patterns found”). Ela não apontou a linha que vaza o CPF. O artigo 12 pede registro de eventos pra rastreabilidade. Não pede que você despeje dado pessoal num arquivo. Já escrevi sobre o CPF que a IA acha e que vaza mesmo assim; aqui o problema é outro: o scanner contou a presença do log, não o que tem dentro.
Três arquivos de uma linha viraram três PASS
Copiei o projeto e criei três arquivos:
echo "# Triagem" > README.md
echo "# Risk assessment" > RISK_ASSESSMENT.md
echo "# Data governance" > DATA_GOVERNANCE.md
Rodei de novo. “Risk assessment document”, “Data governance documentation” e “System description (README)” foram de FAIL pra PASS. O placar foi de 2 pra 5 passando, de 11 pra 8 falhando. Nenhum risco foi avaliado. Nenhum dado foi governado. O scanner checa se o arquivo existe.
Não é defeito escondido. A ferramenta marca essas checagens como “hybrid”, ou seja, precisa de gente olhando. Mas um relatório com “5 passing” num slide de comitê não carrega essa nuance.
O que o AI Act pede de fato
O texto é o Regulamento (UE) 2024/1689, publicado no Jornal Oficial em 12/07/2024. As datas, conferidas no EUR-Lex:
- 02/02/2025: proibições (art. 5) e letramento em IA (art. 4).
- 02/08/2025: regras de modelos de propósito geral, governança e penalidades.
- 02/08/2026: aplicação geral, incluindo transparência do art. 50, com transição de quatro meses pra marcação de conteúdo de sistemas já no mercado.
- Alto risco: o Digital Omnibus on AI, Regulamento (UE) 2026/1744, em vigor desde 27/07/2026, adiou. Sistemas do Anexo III vão pra 02/12/2027. Sistemas do art. 6(1), embutidos em produto regulado, vão pra 02/08/2028.
Por que isso importa pra quem é de saúde: o Anexo III, ponto 5(d), cita “emergency healthcare patient triage systems”. Meu app fictício de triagem cairia ali se rodasse na Europa. E o AI Act alcança fornecedor fora da UE quando a saída do sistema é usada na União.
O primeiro trabalho é decidir se o seu sistema é de alto risco. Isso é leitura do art. 6 e dos anexos, com caso de uso na mão. O scanner não faz essa classificação. Ele parte do princípio de que você precisa dos artigos 9 a 15.
E mesmo pra alto risco, os artigos 9 a 15 não são tudo. O scanner não cobre o art. 13 (instruções e transparência pro implantador), o sistema de gestão da qualidade (art. 17), a avaliação de conformidade (art. 43), o registro na base da UE (art. 49) nem o monitoramento pós-mercado (art. 72).
Mais um detalhe. O banner da ferramenta avisa “€35M or 7% global turnover”. Esse teto do art. 99 vale pra prática proibida. Descumprir obrigação de alto risco tem teto de 15 milhões de euros ou 3% do faturamento.
O que um scanner automático não prova
- Que o sistema é ou não é de alto risco.
- Que o documento de risco tem conteúdo. Ele vê o arquivo, não lê o mérito.
- Que os dados de treino, validação e teste são representativos e tiveram o viés examinado, como pede o art. 10.
- Que existe supervisão humana de verdade. Um
input("confirma?")no código não é processo. - Que o log não vaza dado pessoal. Vi o contrário.
- Qualquer coisa sobre LGPD. As 8 checagens de privacidade são de GDPR.
O README fecha com a frase certa: “This is not a certified compliance test. It is a starting point to identify potential gaps.”
Limites deste teste
Rodei com --no-llm, só regex e checagens estáticas. O modo profundo com Ollama pode achar mais coisa, inclusive o CPF no log. Não testei. Também não subi o gateway, então as 13 checagens de runtime não foram avaliadas. E o projeto tem um arquivo só. Num repositório grande o volume de alertas muda.
Quando não usar
- Pra afirmar a cliente ou auditor que o sistema “está conforme”. Ele não serve pra isso.
- Se o seu problema é só LGPD. Ele não conhece a lei brasileira.
- Se você não vai ler cada FAIL e cada WARN. Placar sem leitura vira teatro de conformidade.
Onde eu usaria: no CI, como lembrete de higiene. Falta tratamento de erro, falta retry, falta proteção contra injection. Isso ele pega bem e rápido.
Fonte e como reproduzir
- Repositório: github.com/airblackbox/airblackbox (README no commit fba66d2, 26/09/2026).
- Pacote: pypi.org/project/air-blackbox, versão 1.16.0.
- Regulamento (UE) 2024/1689: eur-lex.europa.eu/eli/reg/2024/1689/oj.
- Regulamento (UE) 2026/1744, Digital Omnibus on AI: eur-lex.europa.eu/eli/reg/2026/1744/oj.
Pra reproduzir: crie o app.py e o requirements.txt acima numa pasta vazia, instale o pacote num venv e rode air-blackbox comply --scan . -v --no-llm --no-save --standard eu. Depois crie os três arquivos de uma linha e rode de novo.
In English
I ran airblackbox 1.16.0 on a synthetic Python app that logs a fake CPF in plain text. EU mode ran 46 checks: 2 pass, 33 warn, 11 fail. Plain-text logging of personal data passed the Article 12 logging check, and three one-line Markdown files turned three failures into passes. Useful as a CI hygiene check; it does not classify risk and does not prove AI Act compliance.
Última revisão em 07/10/2026.