Categoria: Privacidade e segurança em IA
-
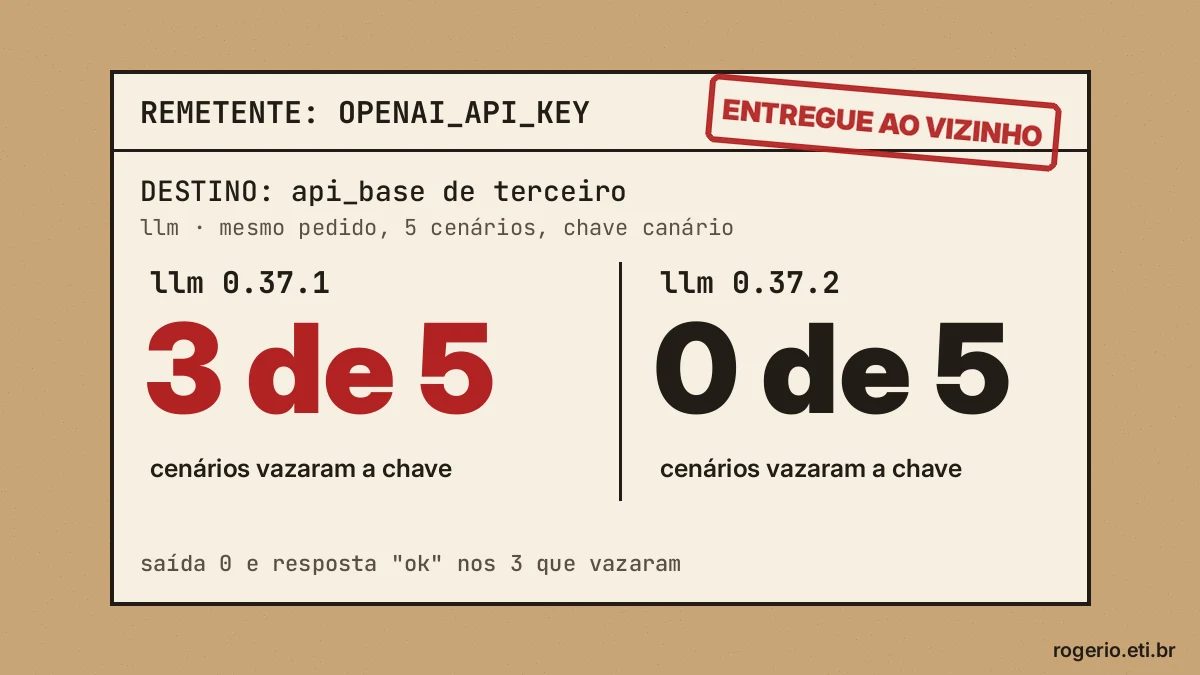
Rodei 5 cenários no llm 0.37.1 e no 0.37.2 contra um endpoint falso com chave canário. O 0.37.1 mandou a chave da OpenAI pro api_base de terceiro em 3 de 5, sem erro nenhum; o 0.37.2, em 0 de 5.
-
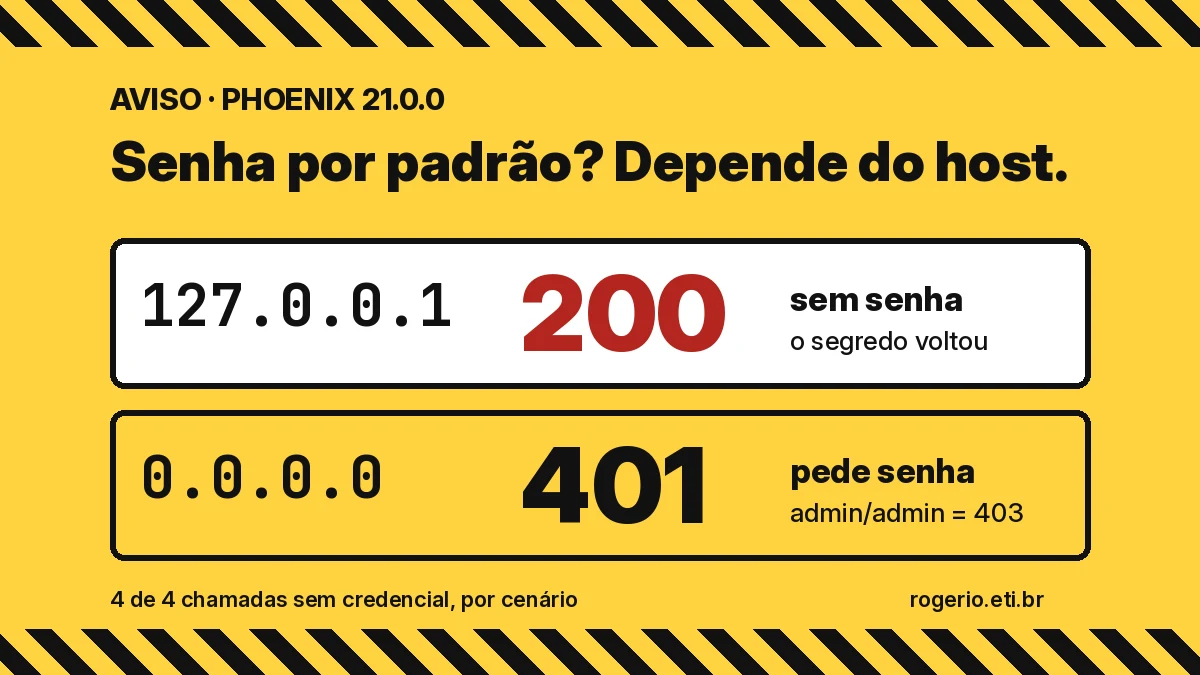
Testei o Phoenix 21.0.0: no padrão (127.0.0.1), 4 de 4 chamadas sem senha responderam 200 e uma chave falsa no prompt voltou inteira. Em 0.0.0.0, as 4 deram 401.
-
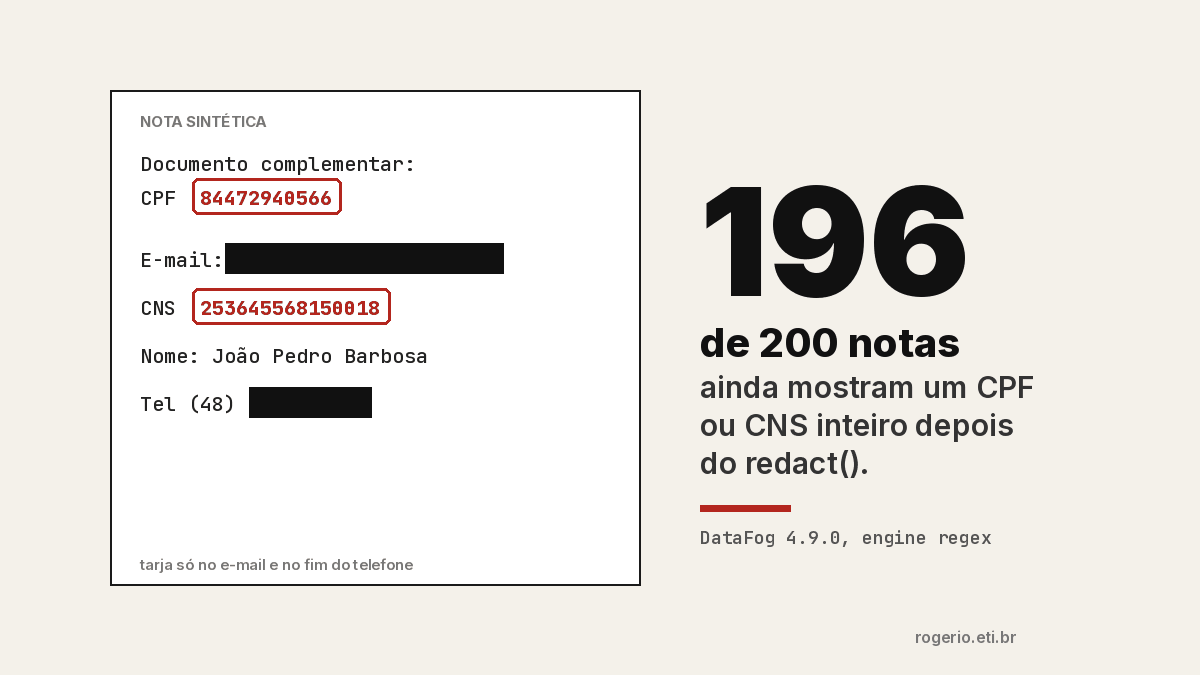
O DataFog 4.9.0 (engine regex) cobriu 26 de 26 e-mails, 8 de 133 CPFs e 0 de 120 CNS em 200 notas sintéticas. Depois do redact(), 196 notas ainda mostravam CPF ou CNS inteiro.
-
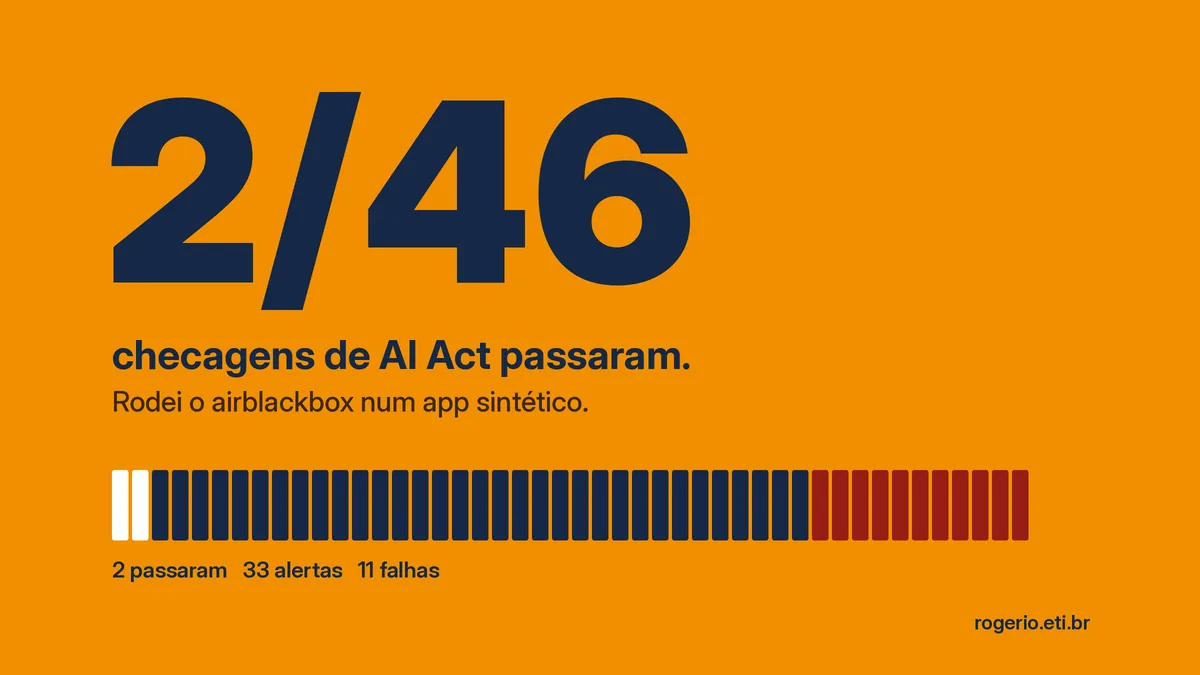
Rodei o airblackbox 1.16.0 num app sintético: 46 checagens, 11 falhas. Três arquivos de uma linha viraram três PASS. O que o scanner prova e o que não.
-
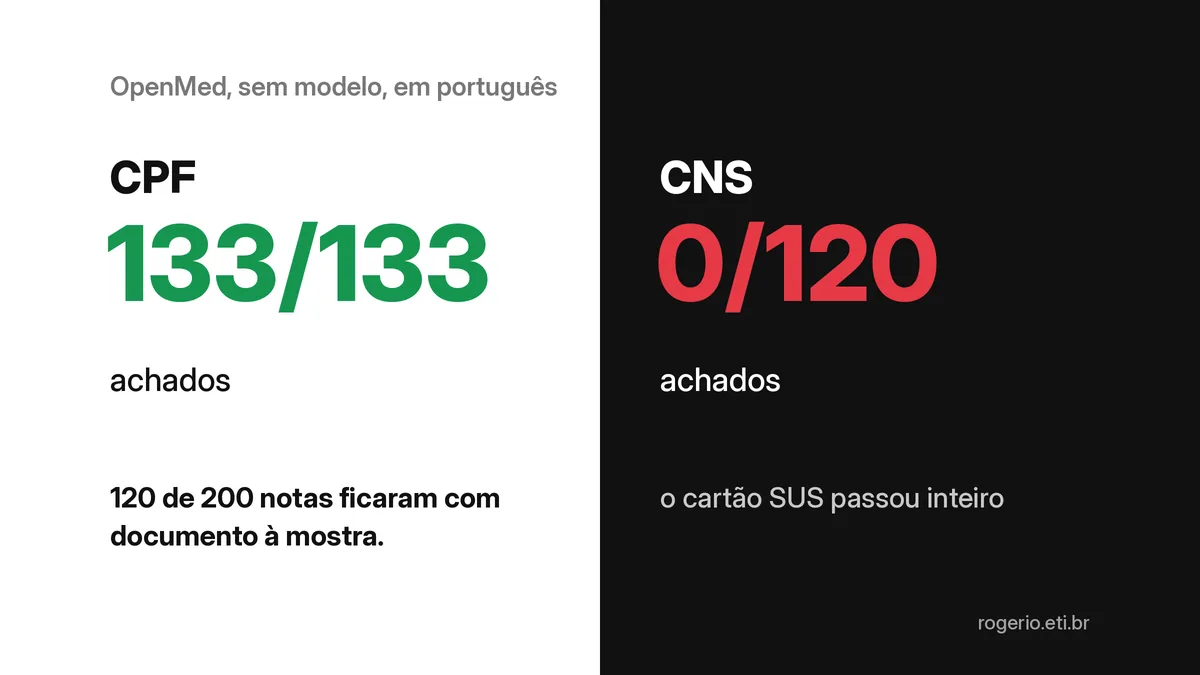
Só a camada sem modelo do OpenMed 2.5.0 rodou: achou 133 de 133 CPFs e 0 de 120 CNS em 200 notas sintéticas. O modelo português ficou de fora.
-
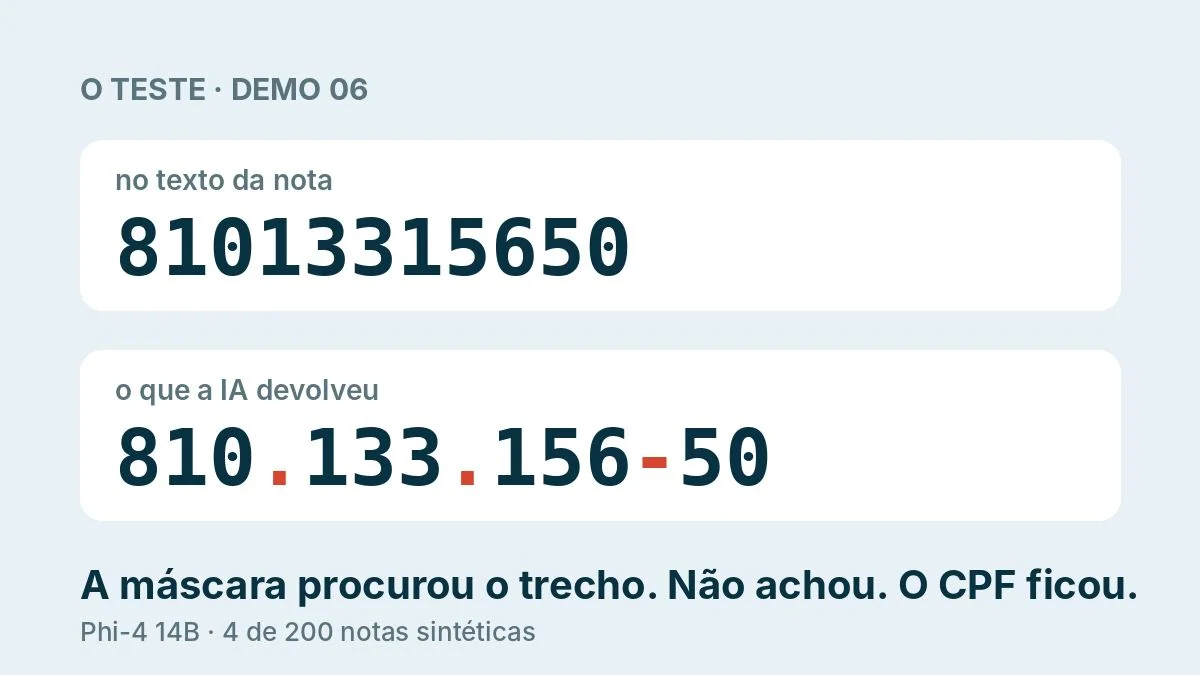
Testei Presidio, presidio-br, Qwen3.8 27B e Phi-4 em 200 notas clínicas sintéticas. O Phi achou o CPF e mesmo assim vazou. Os três testes que eu faço agora e o código pra checar.
-
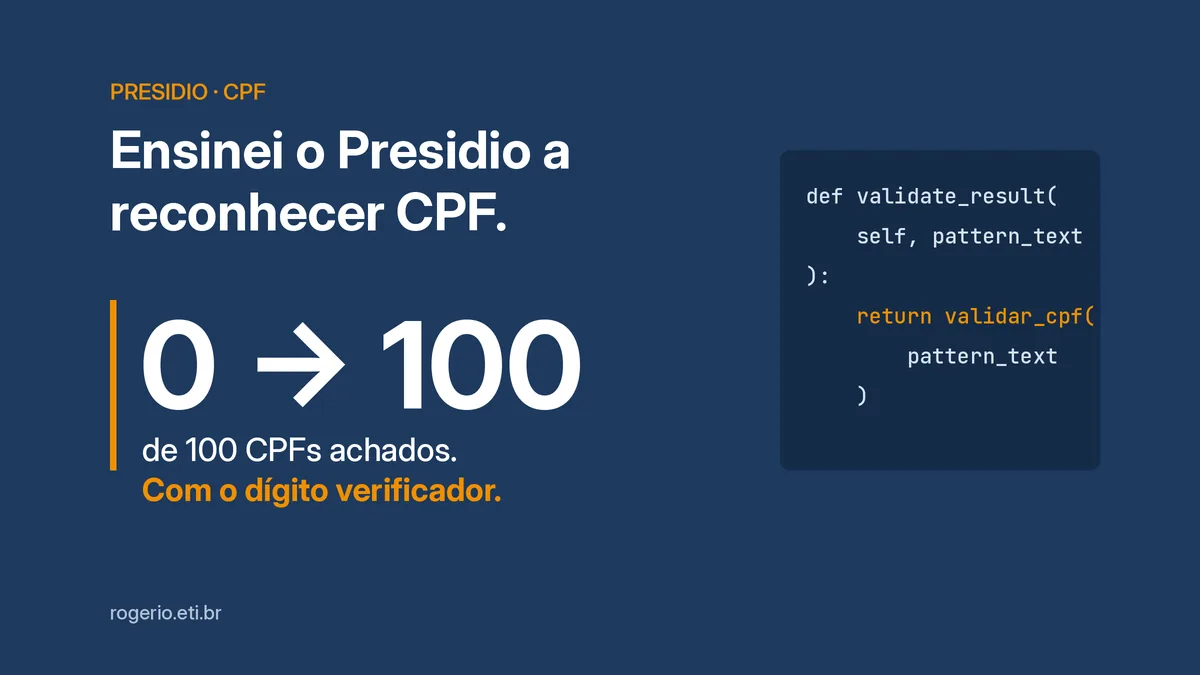
Regex no PatternRecognizer, dígito verificador no validate_result(): recall de CPF 0/100 → 100/100 e falso positivo do só regex 100/100 → 0/100.