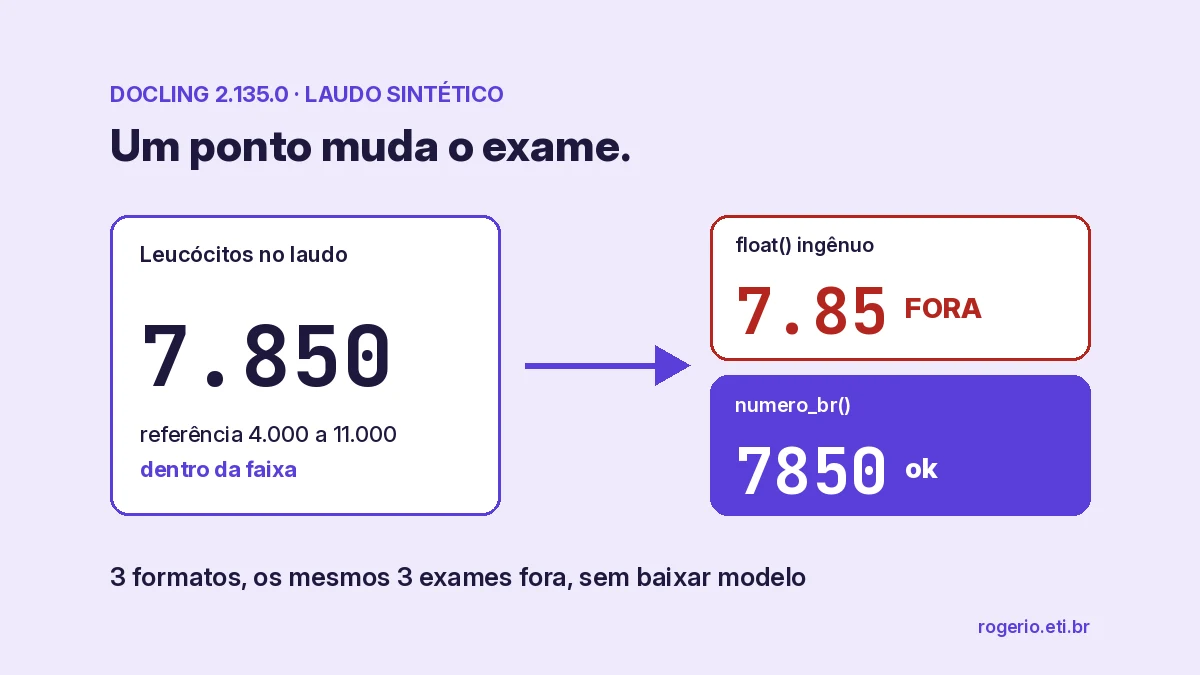
Peguei o mesmo laudo sintético da parte 1 e fui até o fim do caminho: Docling 2.135.0 converte, a tabela vira dado, o código marca o que está fora da referência e cada exame vira um chunk pro RAG. Em DOCX, XLSX e Markdown, os três formatos deram os mesmos 3 exames alterados (hemoglobina, glicose e potássio), em até 0,08 s por arquivo e sem baixar modelo. O problema está no float() ingênuo: ele lê os leucócitos “7.850” como 7,85 e transforma um exame dentro da faixa em alarme.
O código completo está na demo 07 do nursia-research-lab, com 9 testes. Abaixo, passo a passo.
O que a parte 1 deixou pendente
Na parte 1 eu mostrei que o Docling devolve uma tabela Markdown bonita de um DOCX, com o negrito do laboratório preservado. Bonita pra quem lê. O RAG lê chunk. E uma conta simples, “esse valor está fora da faixa?”, não deveria depender do modelo adivinhar olhando um asterisco.
Então a pergunta aqui é outra: o que falta entre a saída do Docling e um chunk que eu confiaria mandar pro LLM?
Passo 1: converter só o que não baixa modelo
O PDF travou na parte 1 porque o pipeline baixa modelos de layout e de tabela na primeira conversão. Aqui eu deixo isso explícito no código. O conversor aceita só DOCX, XLSX e MD. Se alguém mandar um PDF, ele recusa na hora, em vez de tentar a rede sem aviso.
from docling.datamodel.base_models import InputFormat
from docling.document_converter import DocumentConverter

# PDF fica de fora de propósito: o pipeline de PDF baixa modelos na 1ª conversão.
FORMATOS = [InputFormat.DOCX, InputFormat.XLSX, InputFormat.MD]
CONVERSOR = DocumentConverter(allowed_formats=FORMATOS)

doc = CONVERSOR.convert("dados/laudo_sintetico.docx").document
O laudo é gerado por um script do repo (gerar_laudos.py): seis exames, paciente “Maria Teste da Silva (dado sintético)”, e os resultados fora da faixa em negrito no DOCX e no MD, como muito laboratório faz. A XLSX tem a mesma tabela, sem formatação.
Passo 2: a tabela vira DataFrame, com asterisco junto
Todo TableItem do Docling tem export_to_dataframe(). Uma linha e a tabela do laudo vira pandas, com o cabeçalho certo nas colunas:
df = doc.tables[0].export_to_dataframe(doc=doc)
print(df)
Exame Resultado Unidade Referência
0 Hemoglobina **11,2** g/dL 12,0 a 15,5
1 Leucócitos 7.850 /mm³ 4.000 a 11.000
2 Glicose em jejum **126** mg/dL 70 a 99
3 Creatinina 0,9 mg/dL 0,5 a 1,1
4 Potássio **5,8** mEq/L 3,5 a 5,1
5 TSH 2,1 µUI/mL 0,4 a 4,0Repara na coluna Resultado. No DOCX e no MD, a célula chega como "**11,2**", com os asteriscos do negrito dentro do texto. Na XLSX, chega "11,2". O mesmo exame, três formatos, duas strings diferentes. Quem fizer conta direto nessa coluna quebra no primeiro valor.
Passo 3: ler número no formato brasileiro
A conversão que todo mundo escreve primeiro é trocar vírgula por ponto:
float("11,2".replace(",", "."))     # 11.2, certo
float("7.850".replace(",", "."))    # 7.85, errado: são 7.850 leucócitos
float("**11,2**".replace(",", ".")) # ValueError
No laudo brasileiro, ponto é separador de milhar. Leucócitos 7.850/mm³ está dentro da referência (4.000 a 11.000). Lido como 7,85, fica cerca de 500 vezes abaixo do mínimo e vira “fora da referência”. Um alarme falso que nenhum erro de Python acusa.
A função do repo tira a marcação, tira o ponto de milhar e só depois troca a vírgula:
import re

def numero_br(texto: str) -> float:
    """'7.850' -> 7850.0 · '11,2' -> 11.2 · '**5,8**' -> 5.8"""
    limpo = re.sub(r"[*`\s]", "", texto)
    return float(limpo.replace(".", "").replace(",", "."))


def faixa_br(texto: str) -> tuple[float, float]:
    """'4.000 a 11.000' -> (4000.0, 11000.0)"""
    minimo, maximo = texto.split(" a ")
    return numero_br(minimo), numero_br(maximo)
Ela só serve pro padrão brasileiro. Um laudo que escreve “7.85” no padrão americano vira 785 aqui. Por isso o parser mora num lugar só e tem teste.
Passo 4: a comparação com a faixa fica no código
Com número e faixa, “fora da referência” é uma comparação. Não precisa de LLM. E o negrito do laboratório, que o Docling preservou, vira conferência: se o laboratório marcou em negrito e a conta não deu fora, o script avisa.
exames = []
for _, linha in df.iterrows():
    valor = numero_br(linha["Resultado"])
    minimo, maximo = faixa_br(linha["Referência"])
    exames.append({
        "exame": linha["Exame"],
        "resultado": valor,
        "resultado_texto": re.sub(r"[*`]", "", linha["Resultado"]),
        "unidade": linha["Unidade"],
        "referencia": linha["Referência"],
        "negrito_no_laudo": linha["Resultado"].startswith("**"),
        "fora": not (minimo <= valor <= maximo),
    })
Saída real de python laudo_rag.py no DOCX:
laudo_sintetico.docx: 6 exames em 0.08 s
  FORA Hemoglobina          11,2 g/dL (negrito no laudo)
  ok   Leucócitos          7.850 /mm³
  FORA Glicose em jejum      126 mg/dL (negrito no laudo)
  ok   Creatinina            0,9 mg/dL
  FORA Potássio              5,8 mEq/L (negrito no laudo)
  ok   TSH                   2,1 µUI/mL
  HierarchicalChunker: 3 chunks; por exame: 6 chunks
As tabelas e os chunks abaixo estão em results/amostras.txt. Os três negritos do laboratório bateram com os três “FORA” da conta.
Passo 5: um chunk por exame
O Docling tem chunker próprio. O HierarchicalChunker não baixa modelo, então rodei ele também, pra comparar. No DOCX, saíram 3 chunks:
0  Paciente: Maria Teste da Silva (dado sintético) - Coleta: 01/10/2026
1  Hemoglobina, Resultado = **11,2**. Hemoglobina, Unidade = g/dL. Hemoglobina,
   Referência = 12,0 a 15,5. Leucócitos, Resultado = 7.850. [...] TSH,
   Referência = 0,4 a 4,0
2  Valores em negrito estão fora da referência.
A tabela inteira, seis exames, cabe num chunk só, serializada como “linha, coluna = valor”. E a legenda que explica o negrito ficou no chunk 2, separada da tabela. Se o retriever trouxer só o chunk 1, o modelo vê **11,2** sem saber o que o negrito quer dizer.
O chunk que eu gravo é um por exame, com o título do laudo e o resultado da conta escrito por extenso. O nome do paciente não entra:
def chunks_por_exame(doc, exames, origem):
    titulo = next((t.text for t in doc.texts if t.label == "section_header"), origem)
    saida = []
    for e in exames:
        alerta = " FORA DA REFERÊNCIA." if e["fora"] else ""
        texto = (f"{titulo}. {e['exame']}: {e['resultado_texto']} {e['unidade']} "
                 f"(referência {e['referencia']}).{alerta}")
        saida.append({"origem": origem, "exame": e["exame"],
                      "fora": e["fora"], "texto": texto})
    return saida
{"origem": "laudo_sintetico.docx", "exame": "Hemoglobina", "fora": true, "texto": "Laboratório Fictício Ltda - Laudo de exames. Hemoglobina: 11,2 g/dL (referência 12,0 a 15,5). FORA DA REFERÊNCIA."}
{"origem": "laudo_sintetico.docx", "exame": "Leucócitos", "fora": false, "texto": "Laboratório Fictício Ltda - Laudo de exames. Leucócitos: 7.850 /mm³ (referência 4.000 a 11.000)."}Numa busca por potássio, o chunk certo já carrega a faixa e a resposta da conta. Isso eu não testei com retriever. O campo fora também vai como metadado, pra filtrar no banco vetorial sem depender do texto.
O resultado nos três formatos
| Formato | Tempo de conversão | Exames lidos | Fora da referência | Negrito bate com a conta | Chunks do HierarchicalChunker | Chunks por exame |
|---|---|---|---|---|---|---|
| DOCX | 0,08 s | 6 | 3 | sim (3 de 3) | 3 | 6 |
| MD | 0,01 s | 6 | 3 | sim (3 de 3) | 3 | 6 |
| XLSX | 0,01 s | 6 | 3 | sem negrito | 1 | 6 |
Docling 2.135.0, docling-core 2.103.1, Python 3.11, Linux, CPU, uma execução. O tempo do DOCX inclui o aquecimento do conversor, que roda primeiro. Os três formatos marcaram os mesmos exames: hemoglobina, glicose em jejum e potássio.
Os testes
São 9. Os que importam: os três formatos dão os mesmos 3 exames fora; o negrito bate com a conta no DOCX e no MD; a célula do DOCX chega com asterisco; o float() ingênuo erra o 7.850; o chunk por exame não leva o nome do paciente; e um PDF é recusado sem tentar a rede.
def test_conversao_ingenua_erra_o_numero_brasileiro():
    ingenuo = float("7.850".replace(",", "."))
    assert ingenuo == 7.85             # leucócitos 7,85: abaixo de 4.000, alarme falso
    assert numero_br("7.850") == 7850.0
    assert numero_br("**5,8**") == 5.8
    with pytest.raises(ValueError):
        float("**11,2**".replace(",", "."))
$ python -m pytest -s -q
docx: 6 exames, fora = ['Glicose em jejum', 'Hemoglobina', 'Potássio'], 0.07 s
.xlsx: 6 exames, fora = ['Glicose em jejum', 'Hemoglobina', 'Potássio'], 0.01 s
.md: 6 exames, fora = ['Glicose em jejum', 'Hemoglobina', 'Potássio'], 0.01 s
....ingênuo: 7.850 -> 7.85; numero_br: 7850.0
...
9 passed in 6.75sO que não funcionou e os limites
- PDF continua de fora. Deixei o pipeline de PDF de fora de propósito e não rodei ele nesta demo. O caminho documentado é baixar os modelos antes (
docling-tools models download) e passarartifacts_path. Está na parte 1, ainda não rodado. - O HybridChunker também ficou de fora. Ele usa tokenizer baixado do Hugging Face. Comparei só com o HierarchicalChunker, que não baixa nada.
- A referência precisa estar no formato “mín a máx”. “Inferior a 200”, “< 5” ou faixa por sexo e idade quebram o
faixa_br. Laudo real tem tudo isso. - A primeira tabela com coluna “Resultado” ganha. Laudo com várias tabelas, cabeçalho em outro nome ou célula mesclada precisa de mapeamento próprio.
- Um laudo, seis exames, gerado por mim. Os números aqui mostram que o código faz o que diz. Não medem laudo de laboratório de verdade.
- Tirar o nome do chunk não é anonimizar. O arquivo de origem e a data de coleta ainda identificam. Se o laudo for real, passa antes por uma camada de anonimização, e o que acontece quando ela falha eu contei em A IA achou o CPF. E o CPF vazou mesmo assim.
Quando não usar
- O resultado já existe estruturado. Exame que sai do sistema do laboratório em HL7 v2 ou FHIR (Observation com
referenceRangeeinterpretation) já traz a faixa e o “alterado”. Converter de volta a partir do documento é perder informação. - Só tem planilha. pandas lê a XLSX direto, com menos dependência. O Docling compensa quando chega DOCX, XLSX e MD misturados e você quer uma API só.
- A decisão clínica depende do chunk. Isso aqui é pra busca e resumo. Marcar “fora da referência” não é laudo médico, e valor crítico tem que chegar numa pessoa.
Fonte e como reproduzir
- Código, dados sintéticos e testes: nursia-research-lab/demos/07-docling-laudo-rag. Licença MIT.
- Docling v2.135.0: github.com/docling-project/docling/releases/tag/v2.135.0
- Chunking no Docling: documentação, chunking
- Relatório técnico: Docling Technical Report, arXiv:2408.09869, doi.org/10.48550/arXiv.2408.09869
- Parte 1, o teste do Docling em PDF, DOCX e XLSX: Docling 2.135.0: DOCX e XLSX viram tabela Markdown, PDF travou
cd demos/07-docling-laudo-rag
python -m venv .venv && .venv/bin/pip install -r requirements.txt
.venv/bin/python gerar_laudos.py
.venv/bin/python laudo_rag.py
.venv/bin/python -m pytest -s -q
Faz parte do projeto NursIA (PPGINFOS/UFSC, bolsa FAPESC). Todos os dados são sintéticos.
In English
Part 2 of my Docling 2.135.0 test: a synthetic Brazilian lab report in DOCX, XLSX and Markdown goes from Docling table to DataFrame to one RAG chunk per test, with the out-of-range flag computed in code. All three formats flagged the same 3 tests in 0.08 s or less per file, with no model download. The bug was a naive float(), which read “7.850” (7,850 in Brazilian format) as 7.85 and raised a false alarm.
Publicado em 20/10/2026.