Voltei ao hl7gen 0.2.0, o gerador de HL7 v2 sintético que já tinha aparecido na comparação com o validador da HL7. Desta vez a pergunta é outra: de tudo que ele gera, o que chega ao FHIR?
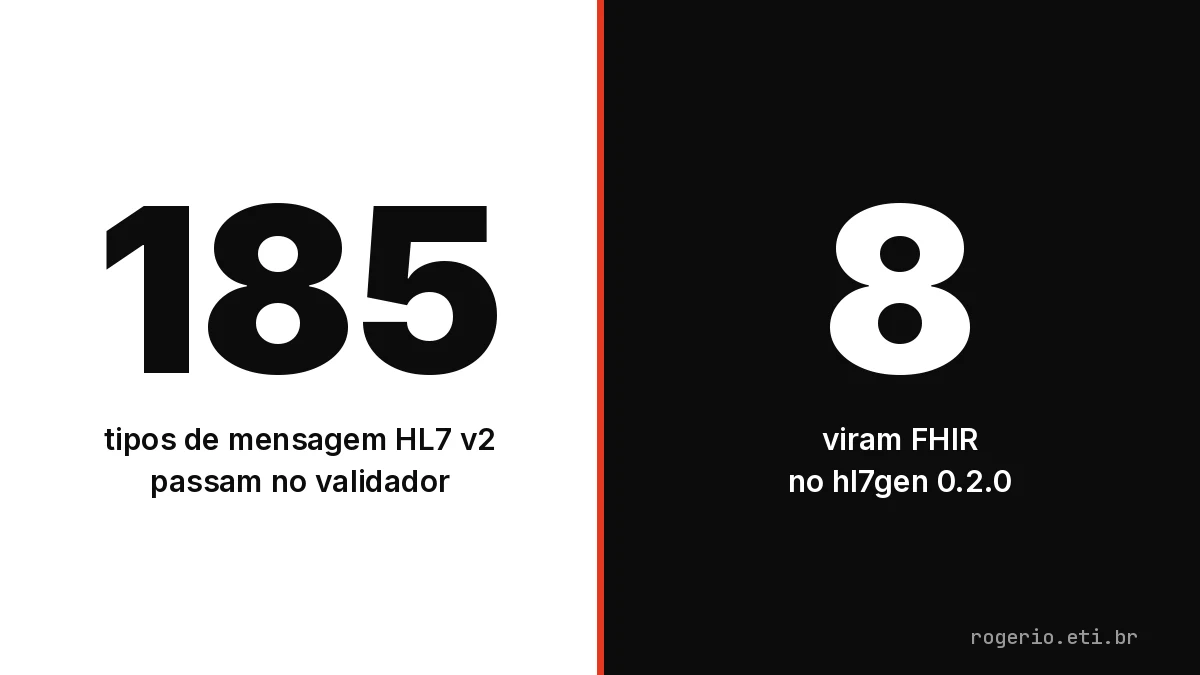
- Todos os 185 tipos de mensagem HL7 v2.5 que ele lista passaram no validador da própria ferramenta. Só 8 viram FHIR.
- Em 200 mensagens de lote, todo sobrenome de paciente saiu como um token aleatório de 8 caracteres.
- Uma mensagem minha, com CPF e CNS sintéticos no PID-3, virou um Patient sem
identifier: os dois números sumiram.
O código, os dados e a saída estão na demo 08 do nursia-research-lab, com 6 testes. Nenhum dado de paciente.
O que é o hl7gen e como rodei
É um pacote Python no PyPI que gera mensagens HL7 v2 sintéticas, valida e converte para FHIR (R4B ou R5). Rodei a versão 0.2.0, em Python 3.11 num venv limpo, só com CPU, sem chave de API e sem rede depois do pip install. A semente do gerador foi fixada em 2026.
python3 -m venv .venv && .venv/bin/pip install -r requirements.txt
.venv/bin/python demo.py          # cerca de 8 minutos em CPU
.venv/bin/python -m pytest -s -q  # cerca de 5 segundos
A rodada completa levou 8 min 25 s numa execução, medida à parte com time. O demo.py faz quatro coisas: percorre os 185 tipos, gera um lote de 100 ADT_A01 e 100 ORU_R01, converte tudo para FHIR R4B, e roda uma mensagem brasileira escrita à mão.
O que deu
| Medida | Resultado |
|---|---|
| Tipos HL7 v2.5 listados | 185 |
Geram e passam no validate |
185 de 185 |
| Convertem para FHIR (R4B e R5) | 8 de 185; 177 com UnsupportedMessageTypeError |
| Lote ADT_A01 e ORU_R01 válido e convertido | 200 de 200 |
Sobrenome (family) é token de 8 caracteres |
200 de 200 |
Telefone com componentes crus do HL7 (^) |
200 de 200 |
Patient sem identifier |
200 de 200 |
Patient sem gender |
74 de 200 |
| Classe do Encounter definida pelo padrão AMB | 130 de 200 |
Observations como valueString / valueQuantity |
300 / 0 |
Uma rodada, hl7gen 0.2.0, Linux. Os números estão em results/resumo.json e a lista dos 185 tipos em results/cobertura.csv.
O que sobra no caminho
Uma mensagem ADT_A01 gerada tem, em média, cerca de 35 mil caracteres: o gerador preenche todos os segmentos e grupos que a estrutura permite, uma ocorrência de cada. O Bundle FHIR que sai dela tem 3 recursos e cerca de 0,7 KB. No lote de ADT_A01 são 63.300 campos não vazios na entrada contra 2.161 valores no JSON de saída. No de ORU_R01, 45.100 contra 2.765. São contagens de naturezas diferentes (a saída inclui constantes como resourceType), mas a ordem de grandeza é clara: quase tudo que o gerador escreve não chega ao FHIR.
O 8 de 185 é escolha declarada. O docstring do módulo de exportação diz que ele cobre ADT, ORU e ORM comuns, “not all ~185 HL7 v2.5 message types”, e recusa os outros em vez de converter pela metade. O código aceita 10 tipos; ADT_A04 e ADT_A08 não estão entre os 185 que o gerador lista, por isso só 8 aparecem na contagem. Pela leitura do código, o mapeamento usa PID-5, 7, 8, 11 e 13, PV1-2 e os OBX. O resto da mensagem fica de fora.
Três detalhes aparecem na contagem acima:
- Gênero. O conversor só mapeia quatro códigos do PID-8 (M, F, O e U). Quando o valor sorteado cai fora deles, o Patient fica sem
gender: 74 de 200. - Classe do atendimento. Só I, O e E têm mapa. Qualquer outro valor do PV1-2 vira ambulatorial (AMB). Foi o que aconteceu em 130 de 200 Encounters.
- Observations. As 300 saíram como texto, nenhuma como quantidade. O conversor só tenta número quando o tipo do OBX-2 é NM, e o tipo é sorteado: nas duas amostras salvas em
results/os OBX são MO e XTN. Não contei quantos dos 300 eram NM.
O caso brasileiro: o CPF não chega
O gerador não sabe de CPF nem de CNS, então escrevi uma mensagem à mão. Os números passam no dígito verificador e não pertencem a ninguém.
MSH|^~\&|SIS|HOSP|DEST|HOSP|20261022090000||ADT^A01^ADT_A01|MSG0001|P|2.5
EVN|A01|20261022090000
PID|1||52998224725^^^BR^CPF~898001234567891^^^BR^CNS||Conceição^João Paulo^Silva||19800315|M|||Rua das Flores 10^Florianópolis^SC||(48)99999-0000
PV1|1|I
O validate aprova a mensagem. Convertida pela API (message_to_fhir, R4B), o Patient que sai é:
{
  "resourceType": "Patient",
  "name": [{"family": "Conceição", "given": ["João Paulo", "Silva"]}],
  "telecom": [{"system": "phone", "value": "(48)99999-0000"}],
  "gender": "male",
  "birthDate": "1980-03-15",
  "address": [{"line": ["Rua das Flores 10"], "city": "Florianópolis", "state": "SC"}]
}
O Patient do Bundle traz nome, telefone, sexo, nascimento e endereço (o Bundle tem também um Encounter, do PV1), e os acentos chegam inteiros. O CPF e o CNS não: no código do conversor, o identifier do Patient é passado como None. Os dois números não aparecem em lugar nenhum do Bundle, e um dos testes da demo confere isso.
Pra teste de integração, o dado pessoal não vaza por engano. Pra quem queria testar o fluxo de CPF e CNS até a RNDS, falta o mapeamento, e ele precisa ser acrescentado por conta própria.
Onde falha o validador
Troquei a data de nascimento da mesma mensagem por 20261345, uma data que não existe.
validate_message  -> valid=True
message_to_fhir   -> ValidationError: 1 validation error for Patient
                     birthDate: Value error, Date value string does not match spec regex
O validate do hl7gen confere a estrutura da mensagem e aprova. Quem quebra é a conversão, com um erro do pydantic em vez de uma mensagem do conversor. A demo grava só o nome da exceção (ValidationError); o texto acima veio da mesma chamada, feita à parte. Aprovado no validate não quer dizer que converte, e muito menos que o conteúdo faz sentido.
Onde isso para de valer
- Só dado sintético, do gerador da própria ferramenta. Isso mostra como o hl7gen se comporta. Não mede nada sobre feeds HL7 reais, que têm Z-segments, codificações e erros que o gerador não imita.
- Dois tipos de mensagem no lote, 100 de cada. Os outros tipos e versões do HL7 diferentes da 2.5 não foram medidos.
- Sem conversor de referência. Não comparei com outro conversor de HL7 v2 para FHIR. “Descarta o CPF” vale para o hl7gen 0.2.0, não para a categoria.
- O
fhir.resourcesleu todos os Bundles. Isso não é o validador da HL7. O validador oficial eu usei na parte anterior. Aqui ele não rodou. - Ficaram de fora:
--realistic(usa a ANTHROPIC_API_KEY),send, o servidor MCP e o playground. - As datas das mensagens geradas dependem do dia em que você roda. As contagens de estrutura não.
Quando eu usaria e quando não
Eu usaria o hl7gen pra encher um ambiente de teste de mensagens ADT e ORU sem tocar em dado real, e pra ver como o seu parser reage a mensagem enorme e cheia de campo estranho.
Não usaria pra testar mapeamento clínico: os nomes são aleatórios, os códigos não existem, e quase tudo que o gerador preenche o conversor ignora.
Fonte e como reproduzir
- Código, resultados e testes: nursia-research-lab/demos/08-hl7gen-hl7v2-fhir. Licença MIT.
- Ferramenta: github.com/mwaseem75/hl7gen, versão 0.2.0 no PyPI.
- Parte anterior, com o validador oficial da HL7: FHIR gerado por IA passa no validador da HL7? Testei 3 modelos.
git clone https://github.com/rogeriorrodrigues/nursia-research-lab
cd nursia-research-lab/demos/08-hl7gen-hl7v2-fhir
python3 -m venv .venv && .venv/bin/pip install -r requirements.txt
.venv/bin/python demo.py && .venv/bin/python -m pytest -s -q
Faz parte do projeto NursIA (PPGINFOS/UFSC, bolsa FAPESC).
In English
I ran hl7gen 0.2.0 on synthetic HL7 v2 data: all 185 message types it lists pass its own validator, but only 8 convert to FHIR. In 200 ADT_A01 and ORU_R01 messages, every patient family name is a random 8-character token and every phone number keeps raw HL7 components. A hand-written message with a synthetic CPF and CNS in PID-3 produces a Patient with no identifier, and an impossible birth date passes validation but crashes the converter.