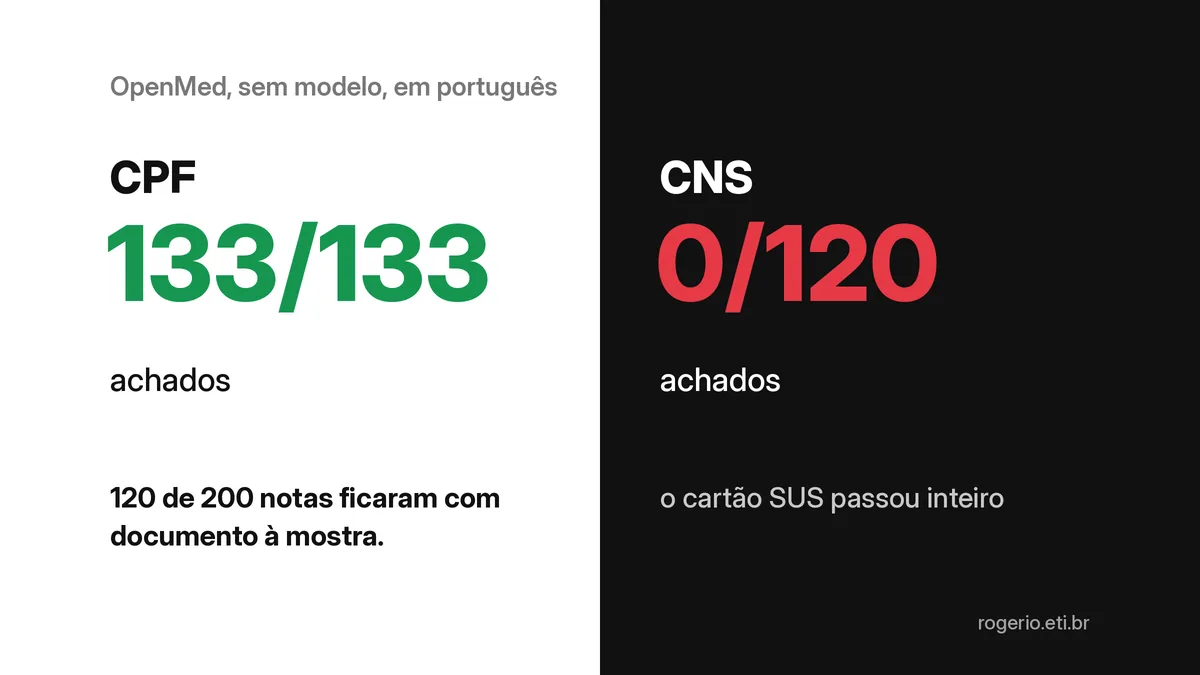
Rodei a camada determinística do OpenMed 2.5.0 (o safety_sweep, sem modelo) nas 200 notas clínicas sintéticas em português da demo 06. Ela achou 133 de 133 CPFs e 0 de 120 números de CNS. Resultado: 120 de 200 notas ficaram com pelo menos um documento à mostra. O Presidio com os reconhecedores do presidio-br, no mesmo corpus, deixou 0 de 200. O modelo português do OpenMed eu não consegui rodar: o download do Hugging Face foi bloqueado na máquina do teste. Então metade deste texto é medida e a outra metade é leitura de documentação, e eu separo as duas.
O resultado do Presidio nesse corpus já está no post A IA achou o CPF. E o CPF vazou mesmo assim. Aqui o assunto é o OpenMed.
O que o OpenMed promete
OpenMed é um SDK Python open source (Apache-2.0) mantido no repositório maziyarpanahi/openmed. A versão no PyPI quando rodei a varredura era a 2.5.0. O README fala em 2.266 entradas no manifesto de modelos e 36 códigos de idioma para PII, 33 deles com modelo próprio. Português (pt) está na lista.
A API de privacidade tem duas funções: extract_pii() devolve as entidades e deidentify() devolve o texto tratado, com métodos mask, replace, hash e shift_dates. O exemplo em português do README é este (não rodei, porque depende do modelo):
from openmed import extract_pii

portuguese = extract_pii("Paciente: Pedro Almeida, CPF: 123.456.789-09, telefone: +351 912 345 678", lang="pt", use_smart_merging=True)
print([(e.label, e.text) for e in portuguese.entities])
Com lang="pt", o código da 2.5.0 escolhe sozinho o modelo OpenMed/OpenMed-PII-Portuguese-SnowflakeMed-Large-568M-v1. É um classificador de tokens (XLM-RoBERTa, 568M parâmetros). O model card reporta F1 micro de 0,8921 e F1 macro de 0,6062 no split de teste “AI4Privacy + Synthetic Portuguese PII”. O treino, segundo o card, juntou o AI4Privacy PII Masking 200K, o Nemotron-PII como semente e cerca de 80 mil amostras sintéticas em português com formato de CPF e telefone +55.
Sobre rede, o README diz que o runtime roda local depois que o modelo está baixado, e avisa que download, adaptadores remotos e caminhos com telemetria podem usar a rede. Leia essa frase com calma antes de pôr em produção.
O que eu rodei e por que só essa parte
O deidentify() funciona em duas etapas. Primeiro o modelo marca as entidades. Depois vem o safety_sweep, uma varredura com regex e validador por idioma que acrescenta o que o modelo não cobriu. No código, os spans do modelo sempre ganham e o sweep só entra onde não há sobreposição. Ou seja: o sweep é o piso. É o que sobra quando o modelo erra.
Como o modelo não baixou (403 na rede da máquina, o SDK abortou com ModelIntegrityError porque não conseguiu conferir o sha256), medi só esse piso. Foi assim:
import json
from openmed.core.safety_sweep import safety_sweep

notas = [json.loads(l) for l in open("data/corpus.jsonl", encoding="utf-8")]
cns, cns_inteiro = 0, 0
for nota in notas:
    achados = safety_sweep(nota["texto"], [], lang="pt")
    for s in nota["spans"]:
        if s["tipo"] == "BR_CNS":
            cns += 1
            cns_inteiro += any(e.start <= s["inicio"] and e.end >= s["fim"] for e in achados)
print(f"CNS cobertos por inteiro: {cns_inteiro} de {cns}")
Saída: CNS cobertos por inteiro: 0 de 120. O teste completo usou a mesma métrica da demo 06 (metricas.py, match estrito de span por tipo). Ambiente: openmed 2.5.0, Python 3.11.15, Linux x86_64 com 2 vCPU e 7 GB de RAM, n=200 notas sintéticas (seed 2026).
| Sistema | Recall CPF | Recall CNS | Notas com documento à mostra | Falso positivo em distratores |
|---|---|---|---|---|
OpenMed 2.5.0, só safety_sweep (sem modelo) |
100% | 0% | 120 de 200 | 5 |
| Presidio 2.2.364 + presidio-br (demo 06) | 100% | 100% | 0 de 200 | 49 |
Os 49 falsos positivos do Presidio vêm quase todos do NER do spaCy (marca de remédio e pressão arterial). O sweep do OpenMed não tem NER, então não dá pra ler essa coluna como vitória dele. E as máquinas são diferentes, por isso deixei o tempo de fora da tabela.
CPF: a varredura acha, com validador
O pacote português tem um padrão de CPF com ou sem pontuação e um validador de dígito verificador (validate_portuguese_cpf). Pegou os 133, inclusive os 66 sem ponto nem traço. Os números de protocolo de 11 dígitos que não passam no dígito não viraram CPF.
CNS: não existe no pacote português
Procurei no código. O pacote pt tem CPF, CNPJ, NIF de Portugal, telefone, data, endereço e CEP. Não tem CNS. O pior é o que acontece com o CNS escrito com espaço: o regex de telefone pega o miolo. Em “806 0454 1465 9087” ele marcou “0454 1465” como telefone. Isso aconteceu em 47 dos 120 CNS. Mascarar o miolo deixa 7 dos 15 dígitos na nota, com cara de tratado.
Confesso que eu esperava o contrário. CNS é o documento que mais aparece em prontuário do SUS, e um SDK com validador de CPF me fez supor que o resto do Brasil viria junto.
Data e endereço
Data: 74 de 98. As 24 que escaparam são todas por extenso sem ano (“3 de março”). O regex exige “de 1985” no fim. Endereço: o padrão pega “Rua do Mirante, 102” e para antes do bairro, então no match estrito deu zero. Essa métrica é dura de propósito (meio endereço também identifica alguém), mas convém saber disso antes de olhar o número.
Também saíram 5 protocolos de 11 dígitos marcados como telefone. Para anonimização, isso é excesso de zelo e não vazamento.
O que eu checaria antes de usar o modelo em português
- Rótulo de CNS. O
config.jsondo modelo padrão de português lista 54 tipos de entidade no estilo AI4Privacy. Não achei rótulo de cartão de saúde nem de número de prontuário. O mais próximo éSSN. Rode umas notas com CNS e veja se ele vira SSN, telefone ou nada. - De onde vem o F1. O 0,8921 do card é num conjunto AI4Privacy mais sintético, sem nota clínica. O F1 macro de 0,6062 diz que os tipos raros vão bem pior que a média. Os exemplos do card usam telefone +351 e Lisboa, que é português de Portugal.
- Limiar. O
extract_pii()usaconfidence_threshold=0.5por padrão. Odeidentify()usa 0.7. Na mesma nota, um pode achar o que o outro deixa passar. - Rede. Baixe o modelo uma vez, depois rode com a rede cortada e confira se nada sai. A própria documentação admite caminhos com telemetria.
- Offset. Classificador de tokens devolve posição no texto e não reescreve o número. Por construção, não deveria repetir o erro do Phi-4 na demo 06, que normalizava o CNS e perdia o span. Isso é leitura de arquitetura. Não medi.
Limites deste teste
- Não rodei nenhum modelo do OpenMed. Medi só o piso determinístico. Com o modelo, o recall de CNS pode subir; pode não subir. Não sei.
- O corpus é sintético e gerado por template, mais limpo que prontuário real. n=200 não separa diferença pequena.
- Os números do Presidio vêm da execução da demo 06 em outra máquina, em 21/09/2026. Os do OpenMed vêm de uma máquina Linux pequena, em 07/10/2026.
- Endereço e data têm fronteira diferente entre o gold e o OpenMed. O match estrito pune isso.
Quando não usar
Não use o OpenMed como única camada se o seu texto tem CNS e você não testou o modelo no seu próprio corpus. A assinatura de extract_pii() e deidentify() aceita custom_recognizer, que parece ser o lugar pra plugar um reconhecedor de CNS. Não testei. Também não use o F1 do model card como argumento de conformidade com a LGPD. O README avisa que usar o SDK não estabelece conformidade com a HIPAA sozinho. Para a LGPD, vale o mesmo raciocínio.
Se o caso é documento brasileiro em texto curto, o Presidio com presidio-br já tem CPF e CNS com dígito verificador e foi medido. O OpenMed pode entrar como segunda opinião em nome, data por extenso e endereço, que é onde o Presidio sofre. Isso é hipótese pro próximo teste, com o modelo rodando.
Fonte e como reproduzir
- Corpus, métrica e números do Presidio: nursia-research-lab, demos/06-anonimizacao-pt (
data/corpus.jsonl,metricas.py,results/tabela.md). - Reconhecedores BR: demos/04-presidio-br.
- OpenMed: github.com/maziyarpanahi/openmed e openmed 2.5.0 no PyPI. Padrões de português em
openmed/core/pii_i18n.py; varredura emopenmed/core/safety_sweep.py. - Modelo padrão de português: OpenMed-PII-Portuguese-SnowflakeMed-Large-568M-v1 (model card e
config.json). - Presidio: data-privacy-stack/presidio, projeto open source.
git clone --depth 1 https://github.com/rogeriorrodrigues/nursia-research-lab
cd nursia-research-lab/demos/06-anonimizacao-pt
python3 -m venv .venv && . .venv/bin/activate
pip install openmed==2.5.0
python3 openmed_sweep.py   # o trecho com safety_sweep da seção 'O que eu rodei'
O script que gerou a tabela completa (run_sweep.py) ainda não está publicado no repositório.
Este teste faz parte do projeto NursIA (PPGINFOS/UFSC, bolsa FAPESC). Só dado sintético.
In English
I ran OpenMed 2.5.0’s deterministic layer (safety_sweep, no model) on 200 synthetic Portuguese clinical notes: 133/133 CPFs found, 0/120 CNS health-card numbers, so 120 of 200 notes still exposed a document; Presidio with presidio-br leaked 0/200 on the same corpus. The default Portuguese model could not be downloaded on the test machine, so its performance is unmeasured; its label set has no CNS type.
Última revisão em 07/10/2026.