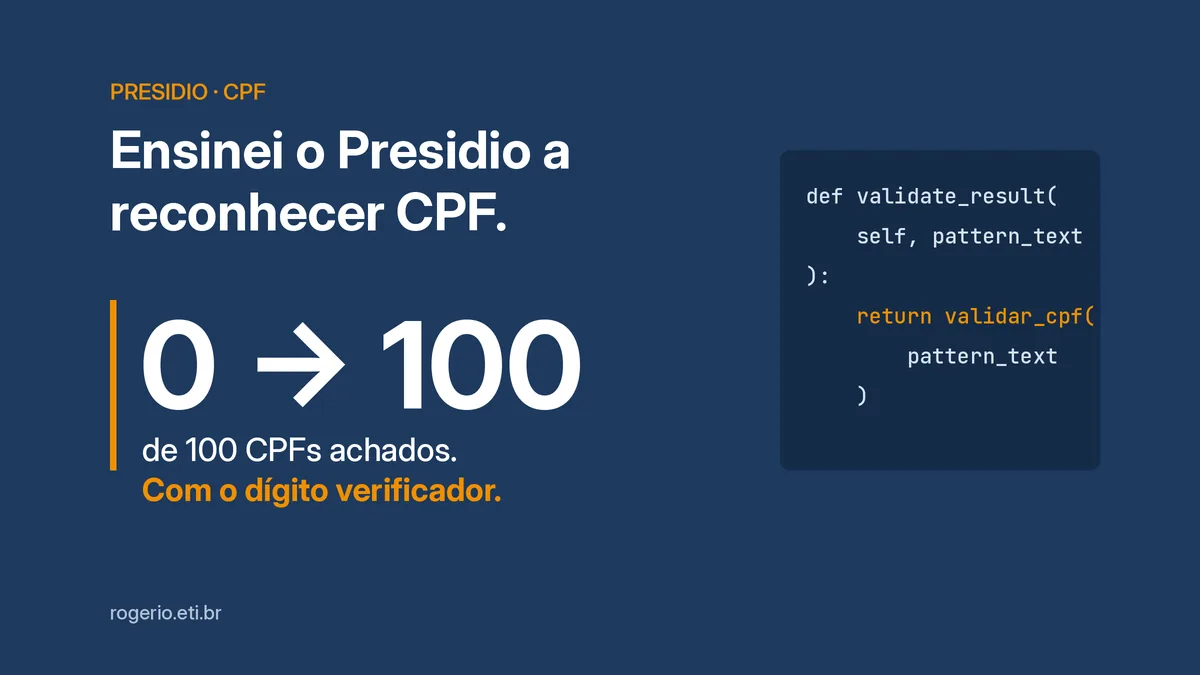
Pro Presidio achar CPF, você cria uma classe PatternRecognizer com o regex do CPF, põe a conta do dígito verificador (mod 11) dentro do validate_result() e registra a classe com analyzer.registry.add_recognizer(). No corpus sintético do presidio-br, isso levou o recall de CPF de 0/100 pra 100/100, o de CNS de 0/100 pra 100/100, e o dígito verificador derrubou o falso positivo do modo só regex, em números de 11 dígitos que não são CPF, de 100/100 pra 0/100. O CRM ainda não está no repo. Abaixo, o código real, passo a passo, e os pontos onde ele ainda deixa passar.
O resultado de vazamento em notas clínicas inteiras já saiu no post A IA achou o CPF. E o CPF vazou mesmo assim. Aqui o assunto é a engenharia do reconhecedor.
Por que o Presidio não acha CPF
O Presidio 2.2.364 traz reconhecedores específicos pra 18 países. Nenhum é do Brasil. Roda ele numa evolução de enfermagem em português e o nome some, mas o CPF passa inteiro:
<PERSON>, CPF 158.813.998-03, admitida na enfermaria com dispneia aos esforços.Pior: no corpus da demo, o Presidio padrão rotulou 17 dos 200 CPF/CNS como PHONE_NUMBER. Os outros 183 passaram em branco. Quem olha só o texto anonimizado acha que funcionou.
A saída foi copiar o desenho que o próprio projeto usa pros documentos de outros países, como o ItFiscalCodeRecognizer e o EsNifRecognizer: um regex de confiança baixa que acha o candidato, e uma validação aritmética que decide se é documento de verdade.
Passo 1: o dígito verificador, sem Presidio
Comecei pela parte que não depende de biblioteca nenhuma. O validador é só aritmética, e por isso dá pra testar sozinho. Este é o validators.py do repo:
def validar_cpf(valor: str) -> bool:
    d = _digitos(valor)
    if len(d) != 11 or d == d[0] * 11:
        return False

    for tamanho in (9, 10):
        soma = sum(int(d[i]) * (tamanho + 1 - i) for i in range(tamanho))
        dv = (soma * 10) % 11
        if dv == 10:
            dv = 0
        if dv != int(d[tamanho]):
            return False
    return True
Repara no d == d[0] * 11. Sequência repetida como 111.111.111-11 fecha a conta, mas a Receita Federal não emite. Sem essa linha, ela vira CPF.
O CNS, o cartão SUS, tem duas regras conforme o primeiro dígito. Começa com 1 ou 2: o número deriva do PIS e os quatro finais são reconstruídos a partir dos 11 primeiros. Começa com 7, 8 ou 9: é provisório, e a soma ponderada com pesos de 15 a 1 tem que dar múltiplo de 11. As duas estão no mesmo arquivo, em validar_cns().
Passo 2: o regex só acha o candidato
O reconhecedor herda de PatternRecognizer. Dois padrões: CPF pontuado, com score 0.5, e onze dígitos corridos, com score 0.1. O score baixo é proposital. Onze dígitos soltos podem ser pedido, nota fiscal, lote.
class BrCpfRecognizer(PatternRecognizer):
    PATTERNS = [
        Pattern(
            "CPF pontuado",
            r"\b\d{3}\.\d{3}\.\d{3}-\d{2}\b",
            0.5,
        ),
        Pattern(
            "CPF sem pontuação",
            r"\b\d{11}\b",
            0.1,
        ),
    ]

    CONTEXT = ["cpf", "cadastro de pessoa física", "documento", "titular"]
Passo 3: validate_result decide se é PII
Aqui está o ponto que faz o reconhecedor prestar. O Presidio chama validate_result() em cada candidato que o regex achou. Se volta True, o score vai pra 1.0. Se volta False, o resultado é descartado. Se volta None, fica o score do regex.
    def validate_result(self, pattern_text: str) -> Optional[bool]:
        if not self.validar:
            return None
        return validar_cpf(pattern_text)
O flag validar existe pra medir. Com ele desligado, o reconhecedor vira “só regex”. Foi assim que a demo comparou os dois modos em 100 números de 11 dígitos que não são CPF:
| Medida | Presidio padrão | + BR só regex | + BR com dígito verificador |
|---|---|---|---|
| Recall BR_CPF (100 CPFs válidos) | 0/100 | n/a | 100/100 |
| Recall BR_CNS (100 CNSs válidos) | 0/100 | n/a | 100/100 |
| Falso positivo BR_CPF (100 distratores) | n/a | 100/100 | 0/100 |
Só regex marca tudo. Com o dígito verificador, o falso positivo zera e o recall não cai.
Passo 4: palavras de contexto
A lista CONTEXT diz ao Presidio quais palavras perto do número aumentam a confiança. Pro CNS ficou ["cns", "cartão sus", "cartao sus", "cartão nacional de saúde", "sus"], com e sem acento, porque prontuário real vem dos dois jeitos.
Sendo honesto sobre o peso disso: com o validador ligado, o CPF válido já sai com score 1.0. O contexto pesa mais no modo só regex e no número sem pontuação, que começa em 0.1. Ele ajuda. Quem segura o resultado é a conta.
Passo 5: registrar no AnalyzerEngine em português
Duas coisas aqui. Primeiro, o AnalyzerEngine precisa de um motor de NLP em português, senão nem carrega o NER em pt. Segundo, os reconhecedores entram no registro de um analyzer já criado. Do demo_presidio_br.py:
def criar_analyzer() -> AnalyzerEngine:
    provider = NlpEngineProvider(nlp_configuration={
        "nlp_engine_name": "spacy",
        "models": [{"lang_code": IDIOMA, "model_name": MODELO_SPACY}],
    })
    return AnalyzerEngine(
        nlp_engine=provider.create_engine(),
        supported_languages=[IDIOMA],
    )
E a função de registro, do recognizers.py:
def registrar_reconhecedores_br(analyzer: AnalyzerEngine, validar: bool = True) -> None:
    """Adiciona BR_CPF e BR_CNS num AnalyzerEngine já criado."""
    analyzer.registry.add_recognizer(BrCpfRecognizer(validar=validar))
    analyzer.registry.add_recognizer(BrCnsRecognizer(validar=validar))
Com IDIOMA = "pt" e MODELO_SPACY = "pt_core_news_sm". O supported_language dos reconhecedores também é "pt".
Passo 6: testes
São 13 testes. Oito no validador, cinco no reconhecedor. Os do reconhecedor chamam analyze() direto na classe, sem spaCy, então não precisam baixar modelo nenhum:
def test_cpf_invalido_e_descartado_com_digito_verificador():
    r = BrCpfRecognizer()
    assert _entidades(r, "Protocolo 158.813.998-04 aberto.") == []


def test_cpf_invalido_passa_no_modo_so_regex():
    r = BrCpfRecognizer(validar=False)
    saida = _entidades(r, "Protocolo 158.813.998-04 aberto.")
    assert [s[0] for s in saida] == ["BR_CPF"]
O par de testes é o argumento inteiro do reconhecedor. O mesmo número, um dígito errado, sai num modo e entra no outro.
E o CRM?
Não entrou. O CRM está no roadmap da demo, no formato com UF (CRM/SC 12345), mas ainda não tem código no repo. E ele vai ser mais difícil que o CPF: não tenho uma conta de dígito verificador pra ele no repo, então quem vai ter que segurar o falso positivo é o contexto (a sigla e a UF), justamente a parte que hoje pesa menos. Quando sair, sai com teste e medição, igual aos outros dois.
Onde ele ainda falha
- Formato fora do regex. O padrão pontuado exige
000.000.000-00completo. CPF com espaço (158 813 998 03), pontuado pela metade (158813998-03) ou com o número quebrado em duas linhas não casa. O CNS aceita espaço, mas não ponto nem hífen. - Distrator que fecha a conta. Os 100 distratores do corpus foram gerados inválidos de propósito. Isso deixa o 0/100 bonito. Na vida real, um número de 11 dígitos qualquer tem 1 chance em 100 de fechar os dois dígitos do CPF, e aí sai como CPF com score 1.0. No CNS provisório é pior: a soma ponderada com peso 1 no último dígito faz cerca de 1 em 11 números de 15 dígitos começando com 7, 8 ou 9 passar.
- CPF por extenso. “Cento e cinquenta e oito…” fica fora do escopo.
- Corpus limpo. Sem ruído de OCR, sem erro de digitação, seed fixa. Todo número aqui é teto.
- O resto da nota. O reconhecedor cobre CPF e CNS. Data, endereço e telefone continuam com os reconhecedores padrão do Presidio e o NER do spaCy, que a demo 04 não mediu, e o
pt_core_news_smchega a marcar “cartão SUS” comoORGANIZATIONem algumas frases.
Quando não usar
- Quando o documento está num campo estruturado. Se o CPF mora numa coluna, apague a coluna. Reconhecedor é pra texto livre.
- Quando o texto é cheio de números de 15 dígitos começando com 7, 8 ou 9 (códigos internos, rastreio). O CNS provisório vai pegar parte deles. Meça antes.
- Como única camada antes de mandar prontuário pra um LLM na nuvem. Ele resolve CPF e CNS. Não resolve nome, data e endereço sozinho.
Fonte e como reproduzir
Código, corpus e testes: nursia-research-lab/demos/04-presidio-br. Licença MIT. Faz parte do projeto NursIA (PPGINFOS/UFSC, bolsa FAPESC), onde o Presidio é a camada de anonimização prevista antes de qualquer dado real entrar no pipeline. Todo CPF e CNS do corpus é sintético, gerado com seed 2026.
cd demos/04-presidio-br
pip install -r requirements.txt
python3 -m spacy download pt_core_news_sm

python3 demo_presidio_br.py
python3 -m pytest tests/
Presidio, projeto open source: data-privacy-stack/presidio, versão 2.2.364. A mesma presidio_br roda sem alteração na demo 06, a da comparação com LLM local.
In English
Presidio 2.2.364 has no Brazilian recognizer. presidio-br adds BR_CPF and BR_CNS as PatternRecognizer subclasses with the mod-11 check digit in validate_result(): recall goes from 0/100 to 100/100 and false positives on non-CPF 11-digit numbers from 100/100 to 0/100 on a synthetic corpus. CRM is not done yet, and a random number still passes the CPF check about 1 time in 100.
Última revisão em 07/10/2026.