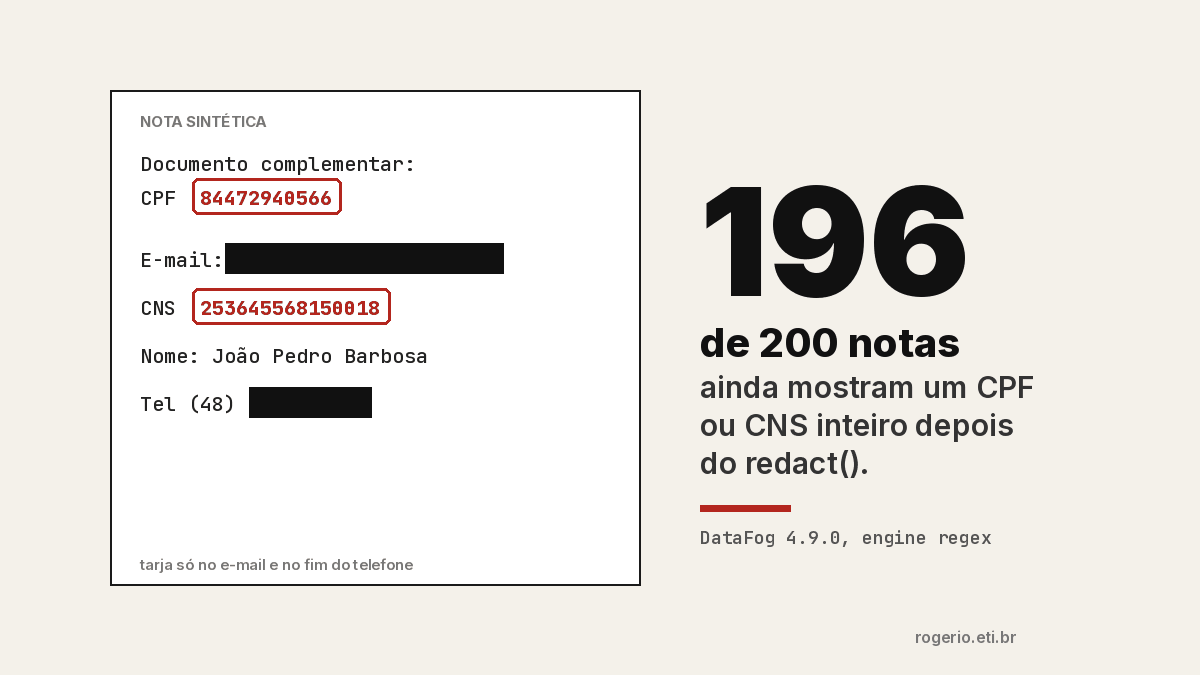
Rodei o DataFog 4.9.0, na configuração padrão, em 200 notas clínicas sintéticas em português. Ele cobriu 26 de 26 e-mails, 8 de 133 CPFs e 0 de 120 CNS. Depois do redact(), 196 das 200 notas ainda mostravam um CPF ou CNS inteiro.
Código, dados e saída gravada: demos/09-datafog-pii-pt no nursia-research-lab.
Como rodei
- DataFog 4.9.0, instalado com
pip install datafog==4.9.0, Python 3.11, CPU. Engineregex, o padrão. Sem modelo, sem chave. - As mesmas 200 notas da demo 06: quatro estilos (evolução, alta, encaminhamento, prescrição), semente fixa, tudo sintético. CPF e CNS passam no dígito verificador, mas são sorteados e não pertencem a ninguém.
- O corpus tem casos difíceis de propósito. Metade dos CPFs vem sem pontuação (66 de 133).
- Telemetria do DataFog desligada no script, com
DATAFOG_NO_TELEMETRY=1eDO_NOT_TRACK=1.
O núcleo do teste são duas chamadas (engine é o motor de detecção; span, o trecho do texto onde o dado está):
entidades = datafog.scan(texto).entities
redigido = datafog.redact(texto, entities=entidades).redacted_text
Para cada dado pessoal do gabarito, medi três coisas. Exato: mesmo início, mesmo fim e tipo certo. Coberto: o dado inteiro cai dentro de alguma entidade, de qualquer tipo. É o que importa pra redigir. Vazou: o texto do dado ainda aparece na nota depois do redact().
O que deu
| Tipo | Suporte | Exato | Coberto | Parcial | Vazou após redact |
|---|---|---|---|---|---|
| 26 | 26 (100%) | 26 (100%) | 0 | 0 | |
| Data | 98 | 17 (17,3%) | 17 (17,3%) | 0 | 81 |
| Telefone | 60 | 0 | 16 (26,7%) | 27 (45,0%) | 17 |
| CPF | 133 | 0 | 8 (6,0%) | 0 | 125 |
| CNS | 120 | 0 | 0 | 0 | 120 |
| Pessoa | 292 | 0 | 0 | 0 | 292 |
| Endereço | 58 | 0 | 0 | 0 | 58 |
Das 200 notas, todas têm CPF ou CNS. Em 196, pelo menos um dos dois continua inteiro depois do redact().
Onde falha, e por quê
CPF e CNS não existem pro engine regex
O engine regex do 4.9.0 lista sete tipos: EMAIL, PHONE, SSN, CREDIT_CARD, IP_ADDRESS, DATE e ZIP_CODE. Não tem CPF, CNS, nome nem endereço brasileiro. Pessoa e endereço em 0% são o esperado, porque o engine não tem esses tipos.
Os 8 CPFs cobertos foram acidente. Todos estavam sem pontuação, e o DataFog os rotulou como PHONE. Dos 66 CPFs sem pontuação, 8 foram cobertos; dos 67 com pontuação, nenhum.
Telefone vira CEP, e o DDD sobra
Telefone no formato 99123-4567 saiu como ZIP_CODE, 43 vezes nas 200 notas. Com DDD, a entidade pega só o final e o DDD fica no texto: 27 casos parciais. Os 16 cobertos por inteiro são celulares sem DDD. Os 17 que sobram são telefones fixos de oito dígitos, no formato 9999-9999, sem entidade nenhuma.
Data: o regex lê mês/dia
Achou 17 de 98. As 50 datas por extenso, como “3 de março”, não entram. Das 48 numéricas, entraram as 17 cujo primeiro campo é até 12. As 31 com primeiro campo acima de 12, como 24/04/25, passaram batido. O regex lê o formato americano, mês antes do dia.
A primeira nota do corpus não mudou nada
Em results/exemplo.txt, a nota 1 tem CNS, CPF, endereço e dois nomes. Depois do redact(), o texto saiu idêntico.
Falso positivo quase não houve
Nos números que não são dado pessoal (lote, leito, dose, pressão, protocolo), o DataFog marcou 2, ambos em protocolo.
Como ler essa tabela
A coluna “Exato” é a métrica de benchmark: o span e o tipo precisam bater. Ela é severa demais pra decidir se o dado vaza. Um CPF rotulado como telefone, por exemplo, conta como erro no “Exato” e como acerto no “Coberto”, porque a tarja cobre os onze dígitos do mesmo jeito. Por isso a coluna que decide é “Coberto”, e a prova final é “Vazou após redact”: procurei o texto original do dado na nota redigida.
Há um ponto cego. “Vazou” olha o texto inteiro do dado. Num telefone parcial, o DDD fica e o resto sai. Por isso o telefone tem 17 vazados e 27 parciais, em vez de 44 vazados. Dado parcial ainda é informação que sobra, e a coluna “Parcial” existe pra isso.
Para comparar
Na demo 06, o Presidio 2.2.364 padrão com spaCy pt deixou CPF ou CNS passar em 200 das 200 notas. Com o presidio-br, o vazamento foi de 0 em 200. Em CPF e CNS, o DataFog regex fica no mesmo lugar do Presidio padrão. Em nome e data, o Presidio com spaCy foi melhor (recall de 82,2% e 49,0%, contra 0% e 17,3% do DataFog). Nenhum dos dois traz reconhecedor de CPF de fábrica. O Presidio aceita um reconhecedor novo; escrevi como em reconhecedor de CPF no Presidio. Eu não testei como acrescentar um padrão de CPF no DataFog.
O que eu faria
- Antes de confiar numa biblioteca de anonimização, rode ela no seu corpus sintético e procure o dado na saída. Não confie no nome da entidade.
- Meça a nota depois do
redact(), não só a lista de entidades. Os dois números diferem: a lista de entidades diz o que foi achado, o texto diz o que sobrou.
Limites
- Só o engine
regex. O DataFog tem engines com NER (spaCy, GLiNER) que baixam modelo. Não rodei. O resultado vale pro que vem compip install datafog, não pra biblioteca inteira. - 200 notas sintéticas, uma semente. Nota real tem mais ruído.
- Mede detecção e o texto depois do
redact(). Não mede reidentificação por combinação de campos. - A opção
localesnão ajuda em português: o 4.9.0 rejeitapte aceita sóde, alemão. Vi pela mensagem de erro; a demo não usa a opção. - Tempo médio de cerca de 0,2 ms por nota nesta máquina (0,15 a 0,21 ms nas rodadas que fiz).
Fonte e como reproduzir
Depois de clonar o repositório e entrar em demos/09-datafog-pii-pt, são três comandos:
pip install -r requirements.txt
python3 demo.py
python3 -m pytest tests -q- Pasta no repositório: demos/09-datafog-pii-pt. Saída gravada em
results/. - DataFog: github.com/DataFog/datafog-python, versão 4.9.0. O LICENSE do repositório é MIT; o classificador do PyPI diz Apache.
NursIA é pesquisa do PPGINFOS/UFSC, com bolsa FAPESC.
In English
I ran DataFog 4.9.0 (default regex engine) on 200 synthetic Brazilian Portuguese clinical notes. It covered 26/26 emails, 8/133 CPF numbers (all mislabeled as phone) and 0/120 CNS numbers. After redact(), 196 of 200 notes still held a full CPF or CNS.